GIL
Python의 멀티스레딩을 공부하다 보면 높은 확률로 GIL(Global Interpreter Lock)이라는 용어를 만나게 됩니다.
보통은 다음과 같이 설명합니다.
CPython에서는 GIL 때문에 여러 스레드가 동시에 Python 코드를 실행할 수 없다.
설명 자체는 틀리지 않습니다. Python 공식 Glossary에서도 GIL을 한 번에 하나의 스레드만 Python bytecode를 실행하도록 보장하는 메커니즘이라고 설명합니다.
하지만 여기에서 자연스럽게 의문이 생겼습니다.
Java에서는 하나의 프로세스 안에서 여러 스레드가 여러 CPU Core를 사용하여 코드를 병렬로 실행합니다. 공유 데이터에 대한 동기화 문제는 synchronized, Lock, Atomic 계열 등을 이용해 개발자가 처리합니다.
그렇다면 Python은 왜 처음부터 이런 방식으로 설계하지 않았을까요?
그리고 GIL이 Python 실행에 반드시 필요한 구조라면, Python 3.13부터 등장한 free-threaded CPython은 어떻게 GIL 없이 실행될 수 있는 걸까요?
이 질문에 답하려면 GIL 자체보다 먼저 Python 코드가 실제 CPU에서 어떻게 실행되는지부터 살펴볼 필요가 있습니다.
CPython Interpreter
다음과 같은 Python 코드가 있다고 하겠습니다.
a = 10
b = 20
c = a + b
CPU는 이 코드를 그대로 이해할 수 없습니다.
현대 CPU가 직접 실행할 수 있는 것은 x86-64, ARM64와 같은 아키텍처의 Machine Code, 즉 기계어입니다.
CPython에서는 Python 소스 코드를 먼저 bytecode라는 중간 명령 형태로 컴파일합니다.
개념적으로 표현하면 다음과 같습니다.
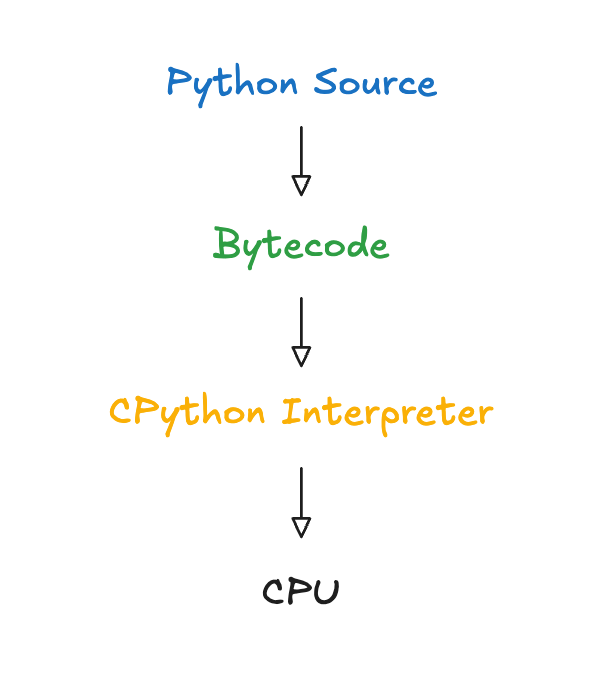
Python의 dis 모듈 역시 CPython bytecode를 분석하기 위한 공식 도구이며, Python 공식 문서는 bytecode가 CPython compiler와 interpreter에서 사용되는 구현 세부사항이라고 설명합니다.
CPython Interpreter 는 C로 구현되고 기계어로 컴파일된 프로그램입니다.
개념을 단순화하면 CPython 내부에는 다음과 같은 처리가 존재한다고 생각할 수 있습니다.
instruction = next_instruction();

switch (instruction) {
    case LOAD:
        ...
        break;

    case ADD:
        ...
        break;

    case STORE:
        ...
        break;
}
실제 구현은 훨씬 복잡하지만 핵심은 같습니다.
CPython이 bytecode에서 ADD와 같은 명령을 발견하면, 이미 기계어로 컴파일되어 있는 CPython 내부의 해당 처리 로직을 CPU가 실행합니다.
JIT Compiler
Interpreter는 bytecode를 실행할 때마다 어떤 명령인지 확인하고 그에 맞는 처리를 해야 합니다.
반복적으로 실행되는 코드라면 이러한 dispatch 과정도 계속 반복됩니다.
이런 비용을 줄이는 대표적인 방법이 JIT(Just-In-Time) Compilation입니다.
JIT는 프로그램을 실행하면서 반복적으로 실행되는 경로, 즉 hot path를 발견하고 해당 경로를 CPU가 직접 실행할 수 있는 Native Code로 컴파일합니다.

JIT가 있다고 해서 Interpreter가 사라지는 것은 아닙니다.
처음 실행하는 코드가 앞으로 한 번만 실행될지 수백만 번 실행될지는 알 수 없습니다. 모든 코드를 처음부터 최적화하여 컴파일하면 컴파일 비용 자체가 더 큰 낭비가 될 수도 있기 때문에 일반적으로 Interpreter를 통해 먼저 실행하면서 정보를 수집하고, 충분히 자주 실행되는 코드만 JIT 대상으로 삼습니다.
이 방식은 JVM의 HotSpot에서도 익숙한 구조입니다. HotSpot은 Interpreter와 JIT compiler를 함께 사용하고, 실행 정보를 바탕으로 자주 실행되는 코드를 최적화합니다. OpenJDK의 HotSpot 설명 자료에서도 bytecode를 실행하는 Interpreter와 C1/C2 JIT compiler의 구조를 확인할 수 있습니다.
CPython 역시 이 방향으로 변화하고 있습니다.
Python 3.11부터는 PEP 659를 통해 Specializing Adaptive Interpreter가 도입되었습니다. 실행 중 실제 타입과 값에 대한 정보를 관찰한 뒤 자주 사용되는 bytecode를 더 구체적인 명령으로 specialization하는 방식입니다.
그리고 Python 3.14의 공식 macOS 및 Windows 배포본에는 실험적인 JIT compiler도 포함되어 있습니다. 다만 현재는 여전히 초기 단계이며 프로덕션 사용은 권장되지 않습니다.
Python도 더 이상 단순히 “bytecode를 그대로 해석하는 Interpreter 언어”라는 한 문장으로만 설명하기 어려워지고 있는 셈입니다.
Multi-threading
이제 다시 GIL로 돌아가 보겠습니다.
GIL은 Global Interpreter Lock의 약자입니다.
전통적인 CPython에서는 Python object에 접근하거나 Python C API를 사용하는 스레드는 GIL을 획득해야 합니다.
결과적으로 하나의 Interpreter 안에서 한 순간에는 하나의 스레드만 Python 코드를 실행하게 됩니다.
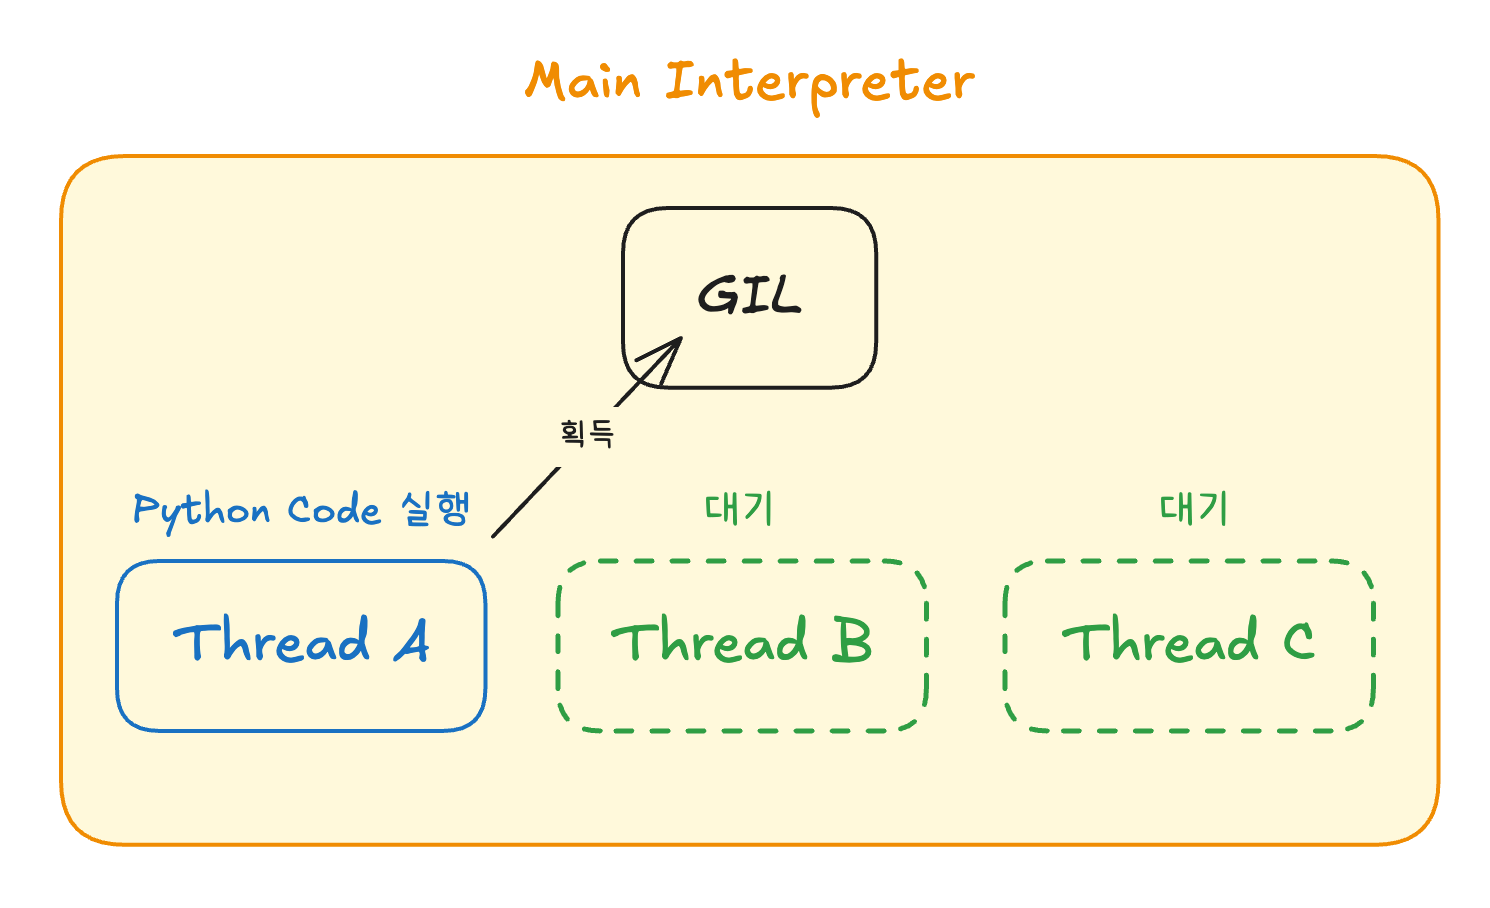
일정 시간이 지나면 실행 권한을 다른 스레드에 넘길 수 있으므로 여러 스레드가 동시성(concurrency)을 갖는 것은 가능합니다.
하지만 CPU-bound Python 작업을 여러 스레드로 나누더라도 일반적인 CPython에서는 Python 코드를 실제로 동시에 실행하기 어렵습니다.
Python 공식 threading 문서 역시 일반적인 CPython에서는 GIL 때문에 한 번에 하나의 스레드만 Python code를 실행할 수 있어 CPU-bound 작업에서는 멀티스레딩의 성능상 이점이 제한된다고 설명합니다.
그렇다면 왜 이런 제약을 일부러 만들었을까요?
GIL은 단순한 성능 제약이 아니라 단순화를 위한 선택이었습니다.
GIL을 이해하는 데 중요한 단서가 CPython의 객체 관리 방식입니다.
CPython의 모든 객체는 내부적으로 reference count를 가지고 있습니다.
예를 들어 다음 코드는 a와 b가 동일한 객체를 참조합니다.
a = SomeObject()
b = a
CPython은 강한 참조가 추가되거나 제거될 때 reference count를 관리하며, 마지막 strong reference가 사라져 reference count가 0이 되면 객체를 해제할 수 있습니다. Python C API에도 Py_INCREF, Py_DECREF 등의 인터페이스가 명시되어 있습니다.
문제는 여러 스레드가 동시에 동일한 객체를 다룰 때 발생합니다.
예를 들어 reference count가 2인 객체를 두 스레드가 동시에 증가시킨다고 생각해 보겠습니다.
현재 count = 2

Thread A: 2를 읽음 → 3
Thread B: 2를 읽음 → 3
올바른 결과는 4여야 하지만 동기화가 없다면 3이 될 가능성이 있습니다.
실제로 Python 공식 C API 문서에서도 GIL이 없다면 두 스레드가 동일 객체의 reference count를 동시에 증가시켰을 때 두 번 증가해야 할 값이 한 번만 증가하는 문제가 발생할 수 있다고 예시를 들고 있습니다.
엄밀하게는 CPython은 Reference Counting만 사용하는 것은 아닙니다.
단순한 reference count만으로는 두 객체의 count가 0이 되지 않을 수 있기 때문에 CPython에는 Reference Counting을 보완하는 Cyclic Garbage Collector가 존재합니다. Python 공식 gc 문서에서도 garbage collector가 Python이 이미 사용하는 reference counting을 보완하며 reference cycle을 처리한다고 설명합니다.
이는 reference count뿐만의 문제도 아닙니다.
dict, list를 비롯한 Python 객체와 CPython Interpreter 내부의 여러 상태 역시 동시에 여러 스레드에서 수정된다면 thread safety를 보장해야 합니다.
여기에는 두 가지 방향이 있을 수 있습니다.
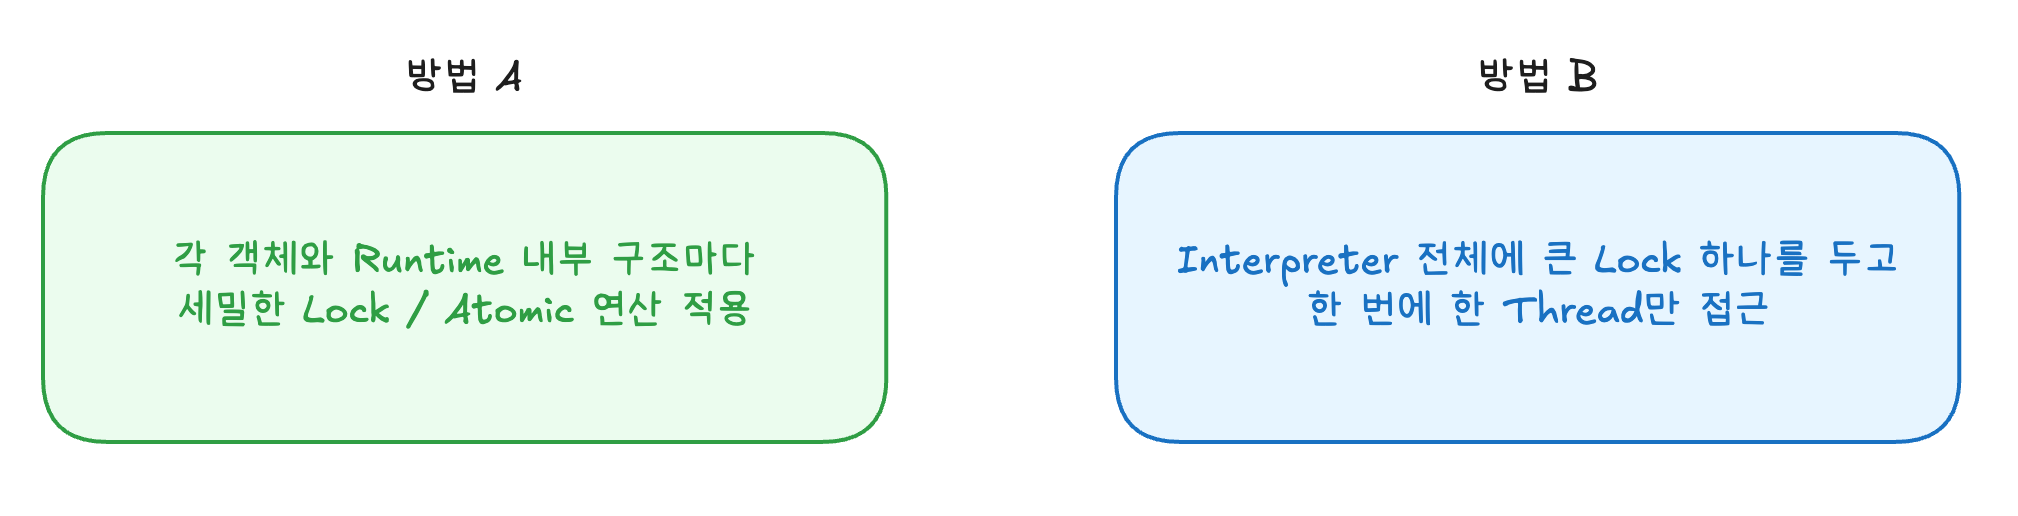
전통적인 CPython은 오랫동안 후자에 가까운 선택을 해왔습니다.
Python 공식 Glossary 역시 GIL이 CPython 구현을 단순화하고 dict 같은 중요한 built-in type을 concurrent access로부터 암묵적으로 안전하게 만드는 대신, 멀티프로세서가 제공하는 병렬성 상당 부분을 포기한다고 설명합니다.
즉 GIL은 단순히 “Python을 느리게 만드는 락”이 아닌, Runtime 내부의 복잡한 동시성 문제를 하나의 큰 Lock으로 단순화한 설계상의 Trade-off였습니다.
그렇다면 Java는 왜 GIL 없이 가능한가?
Java는 여러 스레드가 서로 다른 CPU Core에서 동시에 실행될 수 있도록 설계되어 있습니다. 그렇다고 동기화 문제가 없는 것은 아닙니다.
JVM은 여러 스레드가 객체와 Runtime 내부 상태에 동시에 접근하는 것을 안전하게 처리하기 위해 atomic operation, barrier, safepoint, Stop-The-World와 같은 보다 세밀한 동기화 메커니즘을 사용합니다. 애플리케이션에서도 공유 데이터에 대해서는 synchronized, Lock, Atomic 계열 등을 이용한 동기화가 필요합니다.
즉 CPython이 GIL이라는 하나의 큰 Lock으로 Runtime의 동시성 문제를 단순화했다면, JVM은 여러 스레드의 병렬 실행을 허용하는 대신 더 복잡하고 세밀한 동시성 제어를 Runtime 내부에서 감당하는 방식을 선택했다고 볼 수 있습니다.
Free-threaded
그렇다면 이렇게 질문할 수 있습니다.
멀티코어를 제대로 활용하지 못하는데 왜 GIL이 이렇게 오랫동안 유지되었을까요?
GIL의 비용만큼 이점도 있었기 때문입니다.
CPython 내부 구현을 단순하게 유지할 수 있었고 Python 객체 모델과 C Extension 생태계 역시 오랫동안 GIL이 존재한다는 전제 아래 발전했습니다.
그리고 모든 멀티스레딩이 GIL 때문에 의미가 없는 것도 아닙니다.
Python 공식 문서에 따르면 blocking I/O를 수행할 때는 GIL을 해제합니다. 일부 C Extension 역시 오래 걸리는 계산을 수행하는 동안 GIL을 해제할 수 있습니다.
예를 들어 한 스레드가 네트워크 응답을 기다린다면 다른 스레드에서는 Python 코드 실행이 가능하기 때문에 웹 요청, DB 호출, 파일 처리와 같은 I/O-bound workload에서는 Thread가 여전히 유용합니다.
CPU 연산이 정말 중요할 때는 multiprocessing을 사용하거나 NumPy, PyTorch 같은 C/C++ 기반 라이브러리가 실제 연산 과정에서 GIL을 벗어나는 방식도 사용되어 왔습니다.
즉 오랫동안 GIL은 완벽하지는 않아도 실용적인 Trade-off였습니다.
하지만 하드웨어가 변하면서 단순함의 비용이 커졌습니다.
현대 CPU는 단일 Core 성능만 계속 높이는 대신 많은 Core를 제공하는 방향으로 발전하여, 8 Core, 16 Core, 그 이상의 CPU도 흔해졌습니다.
AI/ML, 데이터 처리, 과학 계산 등 Python이 사용되는 workload 역시 점점 더 많은 병렬성을 요구합니다.
그런 상황에서 CPU-bound Python Thread는 GIL 하나를 두고 실행권을 교대해야 한다면 GIL의 비용이 과거보다 크게 느껴질 수밖에 없습니다.
PEP 703 역시 GIL을 Python에서 multi-core CPU를 효율적으로 활용하는 데 장애물이 되는 global bottleneck으로 설명하며 특히 AI/ML과 scientific computing을 주요 동기로 언급합니다.
결국 과거에는 구현 단순성을 얻기 위한 합리적인 선택이었던 GIL이 멀티코어 환경에서는 확장성을 제한하는 요소가 된 것입니다.
그래서 PEP 703은 CPython에서 GIL을 선택적으로 제거할 수 있도록 하는 변경을 제안했고, Python 3.13에서는 GIL을 비활성화할 수 있는 free-threaded build가 실험적으로 도입되었습니다.
그리고 Python 3.14에서는 한 단계 더 나아가, PEP 779가 승인되면서 free-threaded Python은 더 이상 단순 실험 기능이 아니라 공식적으로 지원되는 선택적 빌드가 되었습니다. 다만 아직 일반 CPython의 기본 실행 방식으로 전환된 것은 아닙니다.
Python 공식문서에서도 free-threaded 실행에서는 GIL을 비활성화함으로써 여러 스레드가 여러 CPU Core에서 병렬로 실행될 수 있다고 설명합니다.
하지만 여기서 중요한 사실은 GIL을 제거했다고 동기화가 사라지는 것은 아니라는 것입니다.
GIL이 있었을 때는 큰 Lock 하나가 많은 내부 상태를 보호했지만, GIL을 제거하면 각각의 상태를 여러 Thread가 동시에 접근해도 안전하도록 만들어야 합니다.
PEP 703을 보면 GIL 제거를 위해 CPython 내부에 상당한 변경이 필요하다는 것을 확인할 수 있습니다.
Reference Counting 방식도 변경되어야 하고, 객체에 대한 세밀한 Lock, 메모리 allocator의 thread safety, Interpreter specialization의 동기화, C Extension의 thread safety 등 다양한 문제가 새롭게 등장합니다.
실제로 기존 C Extension 중에는 GIL이 있다는 전제 아래 작성된 코드도 존재하기 때문에 free-threaded 환경에서 안전하지 않다면 GIL을 다시 활성화할 수도 있습니다. Python 공식 free-threading 문서에서도 일부 third-party extension은 아직 free-threaded 실행을 지원하지 않아 GIL을 다시 활성화할 수 있다고 설명합니다.
마치며
GIL은 처음부터 잘못된 설계였다기보다 당시 CPython이 구현의 단순성과 성능 사이에서 선택한 현실적인 Trade-off에 가깝다고 생각합니다.
하지만 멀티코어 CPU가 보편화되고 Python의 활용 영역이 AI/ML, 데이터 처리, 고성능 컴퓨팅으로 넓어지면서 상황이 달라졌습니다. 이제는 GIL이 제공하는 단순성보다 제한되는 병렬성의 비용이 더 중요해지고 있고 free-threaded CPython은 이러한 변화에 대한 선택입니다.
결국 GIL의 변화는 단순히 Python의 멀티스레딩 성능을 개선하는 이야기가 아니라 환경의 변화에 따라 Runtime이 어떤 Trade-off를 선택하는지도 함께 변할 수 있음을 보여주는 사례라고 생각합니다.
'Lang > Python' 카테고리의 다른 글
| [Python] (3) Execution Model (0) | 2026.09.22 |
|---|---|
| [Python] (2) Object Model (0) | 2026.09.21 |
| Python (4) - 내장 함수, 표준 라이브러리, 외부 라이브러리 (2) | 2025.05.18 |
| Python (3) - 클래스, 모듈, 패키지, 예외 처리 (0) | 2025.05.13 |
| Python (2) - 제어문, 함수, 입출력 (0) | 2025.05.02 |