Execution Model
앞서 Object Model에서는 Python의 변수와 객체를 다음과 같은 관계로 살펴보았습니다.
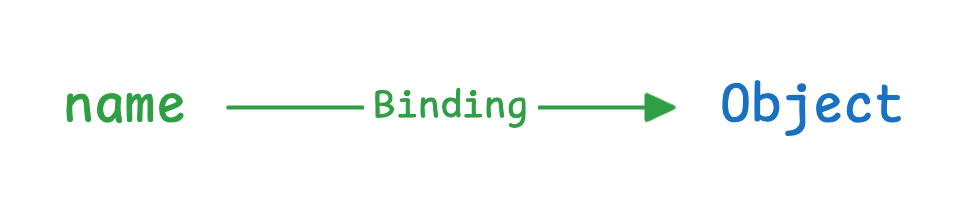
그렇다면 Python은 이 코드를 어떻게 실행할까요?
Python은 소스 코드를 CPU가 직접 실행하도록 전달하지 않습니다.
CPython에서는 Python 소스를 컴파일하여 Bytecode를 만들고 이를 실행하기 위한 Frame을 구성한 뒤 Bytecode Interpreter가 명령을 하나씩 처리합니다.
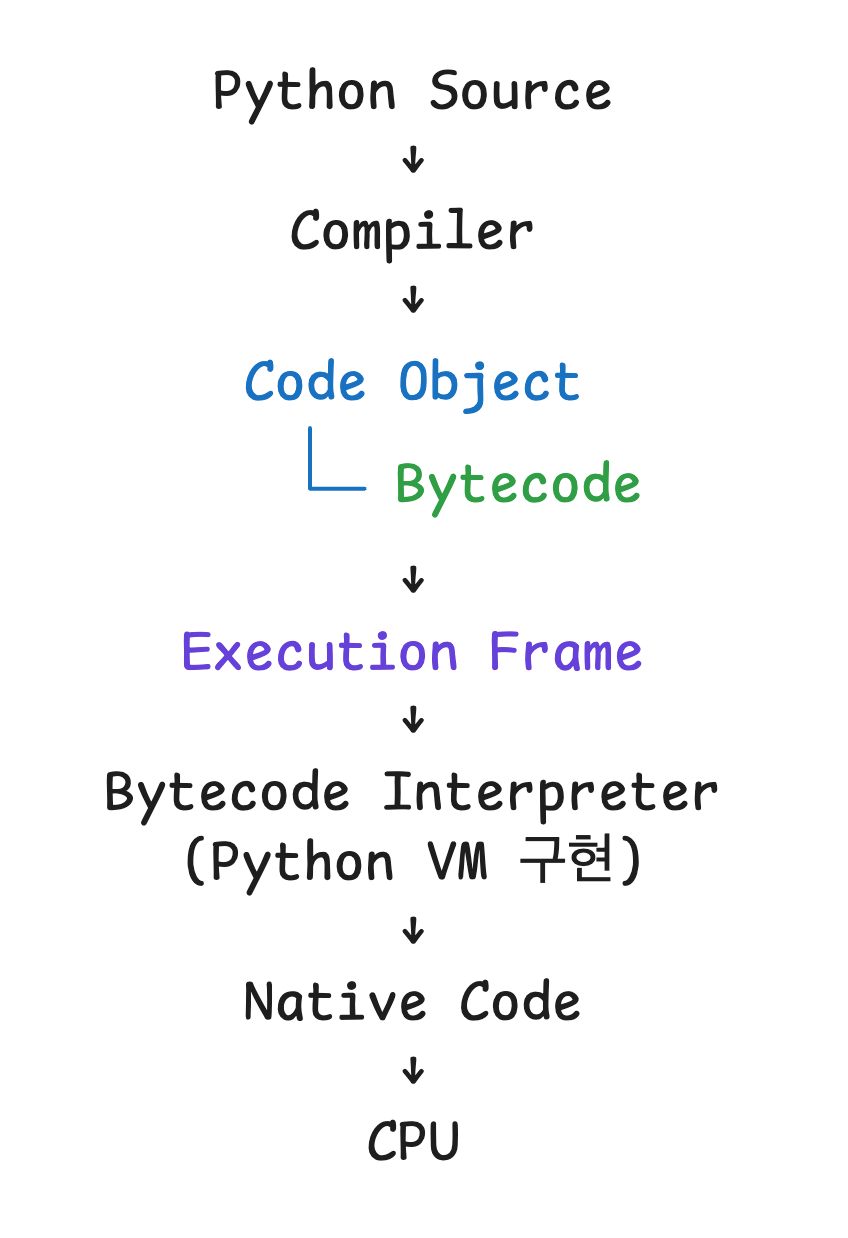
전체적인 흐름은 다음과 같습니다.
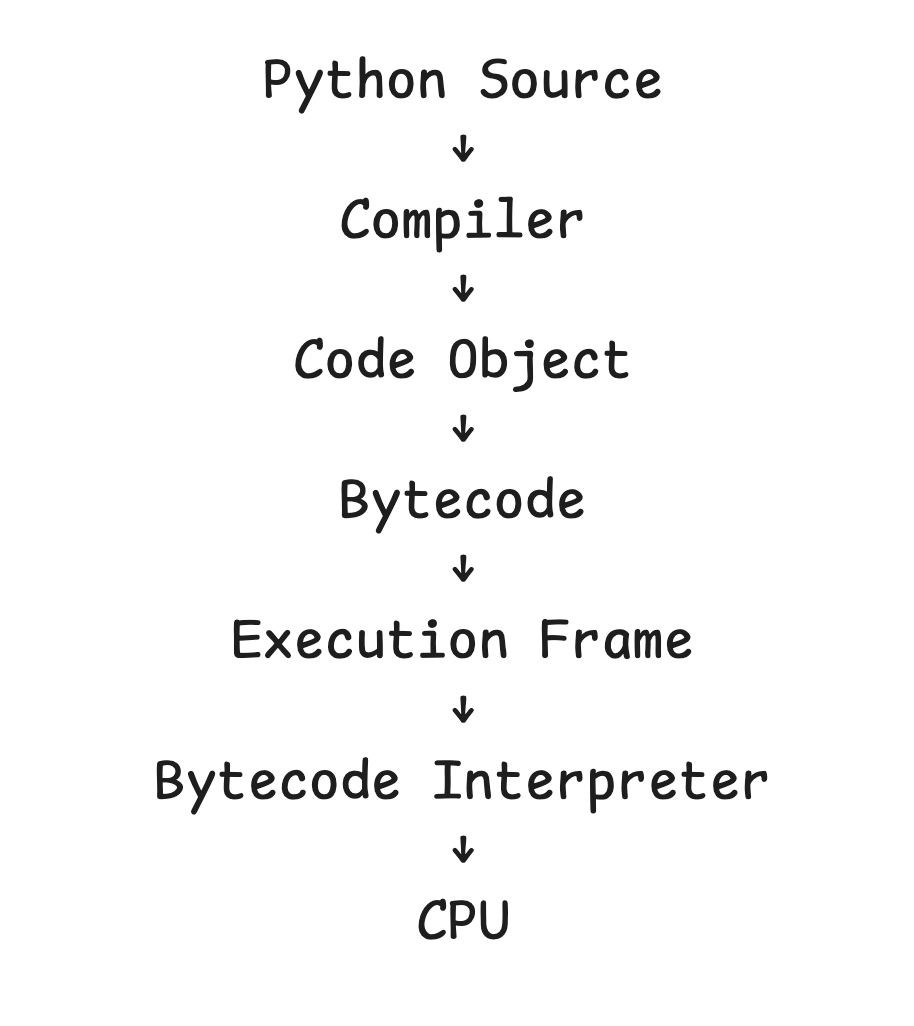
이번 글에서는 Python의 Execution Model을 중심으로 Compiler, Code Object, Bytecode, Frame, Call Stack 그리고 CPython Runtime의 관계를 살펴보겠습니다.
Compiler
Python은 일반적으로 인터프리터 언어라고 부르지만 Python 소스 코드가 곧바로 한 줄씩 CPU에서 실행되는 것은 아닙니다.
CPython은 먼저 Python 소스 코드를 내부 표현인 Bytecode로 컴파일합니다.
Python 공식 Glossary에서도 Python source code가 Bytecode로 컴파일되며 Bytecode는 CPython Interpreter에서 사용하는 Python 프로그램의 내부 표현이라고 설명합니다.
개념적인 흐름은 다음과 같습니다.
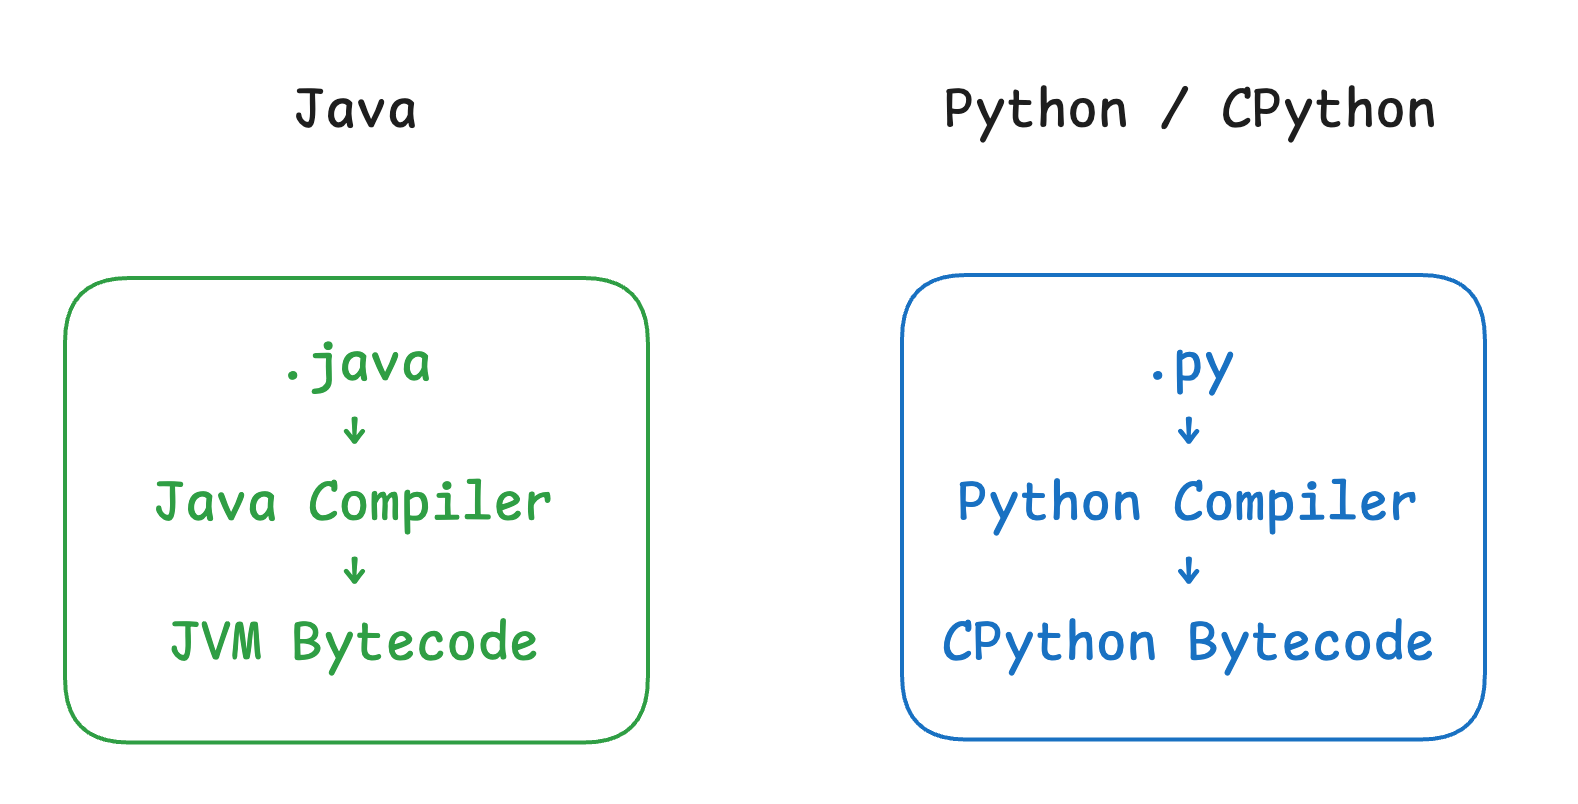
다만 중요한 차이도 있습니다.
Java의 Bytecode는 JVM이라는 명확한 실행 규격을 대상으로 하는 반면, Python Bytecode는 Python 언어 자체의 표준 규격이 아닙니다.
특히 CPython Bytecode는 CPython의 구현 세부사항이며 Python 버전에 따라 명령이 추가되거나 변경될 수 있습니다. 공식 dis 문서 역시 CPython Bytecode의 버전 간 호환성을 보장하지 않는다고 명시하고 있습니다.
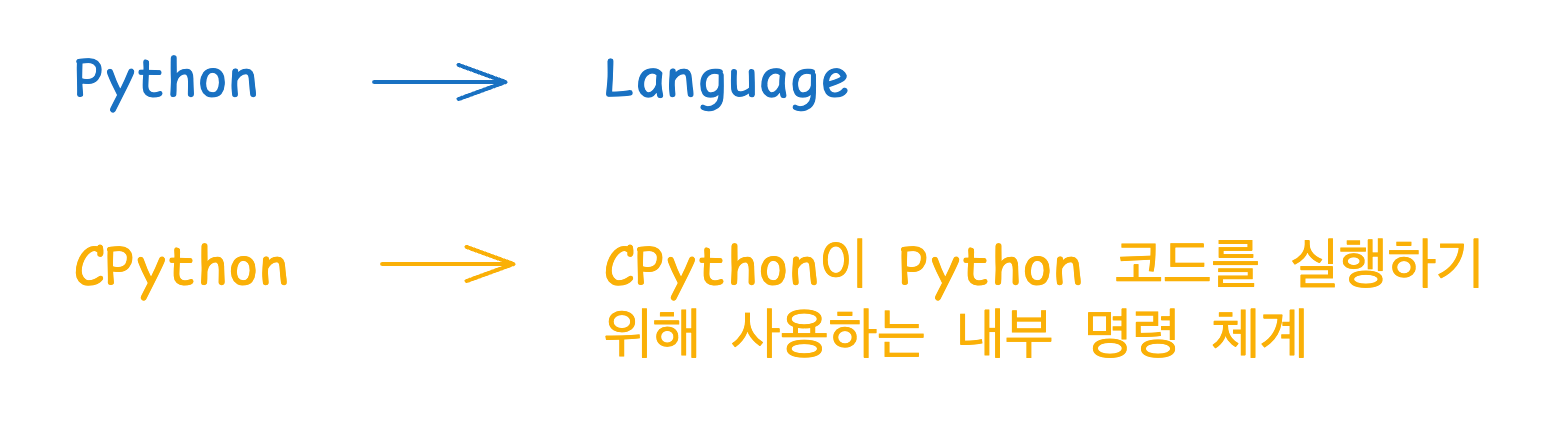
즉 Python이라는 언어와 CPython Bytecode는 구분해야 합니다.
Code Object
컴파일된 Python 코드는 단순히 Bytecode 배열만 존재하는 것이 아니라 Code Object라는 Python 객체로 표현됩니다.
Python 공식 Data Model에서는 Code Object를 Bytecode로 컴파일된 실행 가능한 Python 코드를 나타내는 객체라고 설명합니다.
예를 들어
def add(a, b):
    return a + b
라고 정의하면 함수 객체에서 Code Object를 확인할 수 있습니다.
print(add.__code__)
# <code object add at 0x1077853e0, file "script.py", line 1>
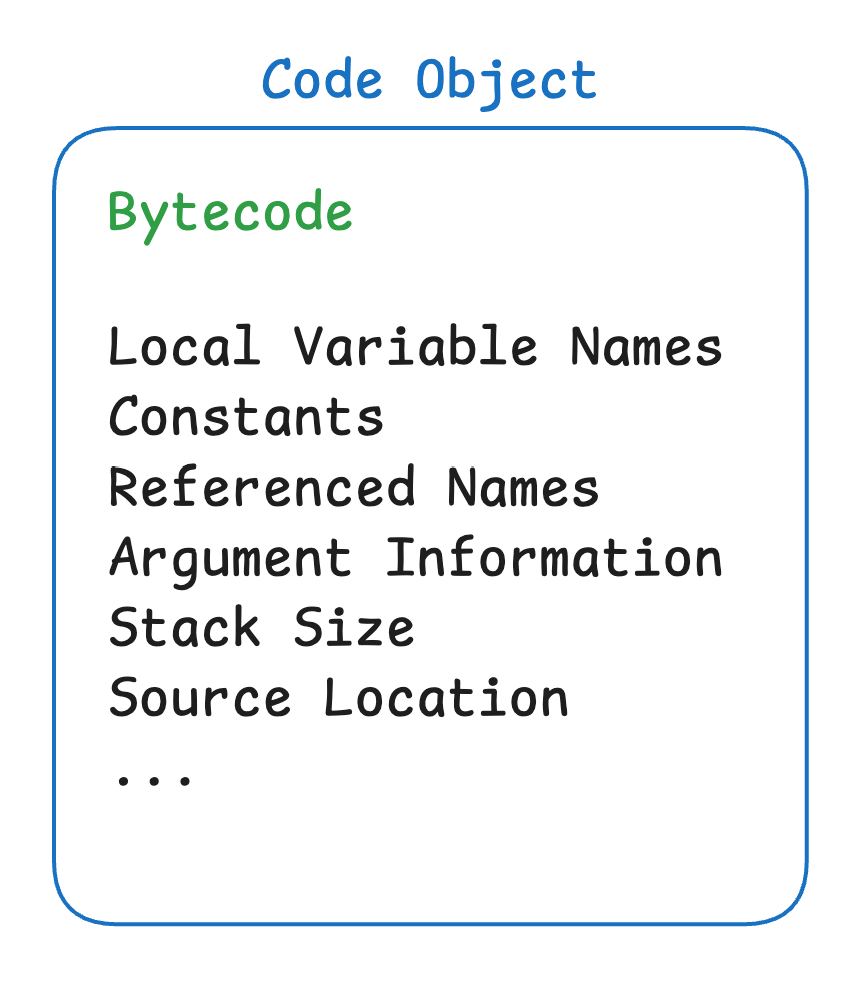
또한 Code Object에는 Bytecode뿐만 아니라 실행에 필요한 여러 정보가 포함됩니다.
print(add.__code__.co_varnames)
# ('a', 'b')
print(add.__code__.co_consts)
# (None,)
print(add.__code__.co_code)
# b'\x80\x00W\x01,\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00#\x00'
예를 들어 co_varnames에는 지역 변수 이름이, co_consts에는 코드에서 사용하는 상수가, co_code에는 Bytecode instruction sequence가 저장됩니다.
개념적으로는 다음과 같습니다.
여기서 Function Object와 Code Object는 서로 다른 객체라는 점도 중요합니다.
def add(a, b):
    return a + b
에서 add는 Function Object입니다.
그리고
add.__code__가 해당 함수의 실행 코드를 나타내는 Code Object입니다.
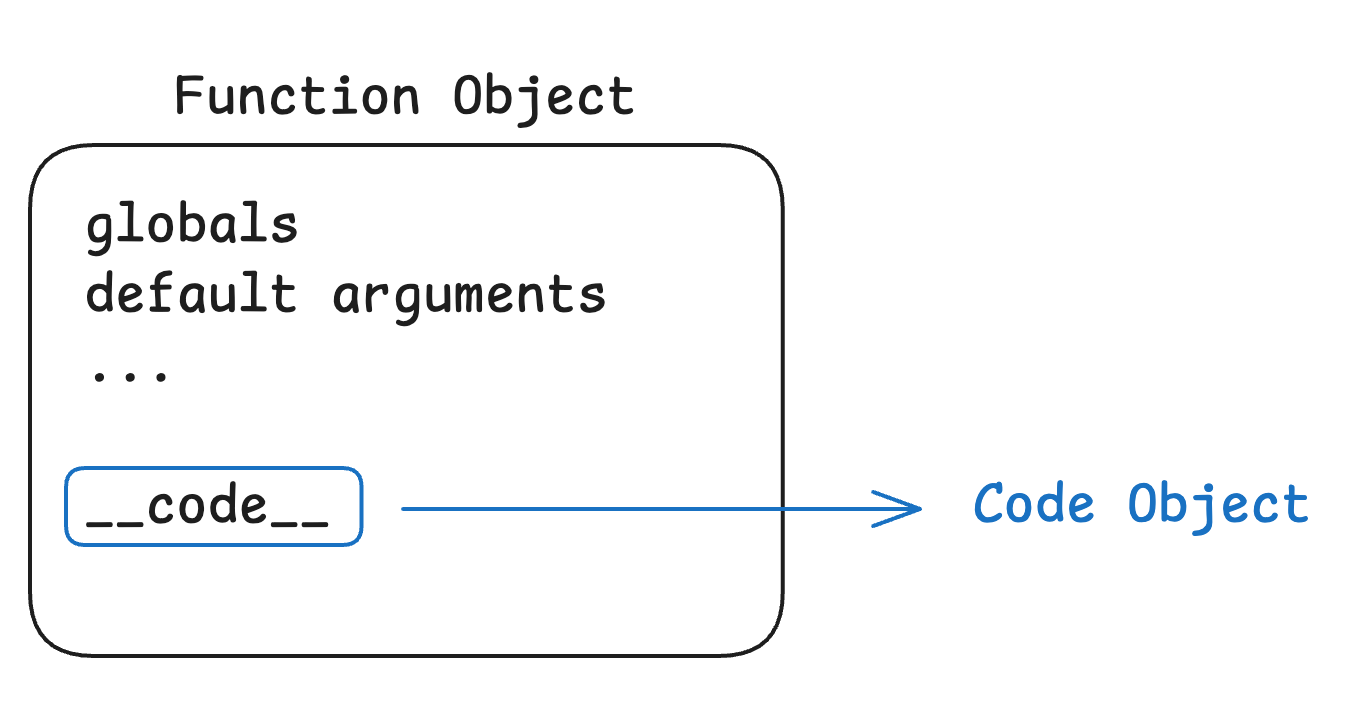
공식 Data Model에서도 Function Object는 자신이 정의된 module의 globals 등을 가지고 있는 반면, Code Object 자체는 실행 Context를 가지지 않는다고 구분합니다.
즉 Code Object는 "무엇을 실행할 것인가" 를 가지고 있고,
실제 실행에 필요한 "어떤 환경에서 실행할 것인가" 는 이후 Frame을 통해 결정됩니다.
Bytecode
Bytecode는 CPython이 실행하는 중간 명령어입니다.
다음 함수의 Bytecode는 표준 라이브러리의 dis 모듈을 통해 확인할 수 있습니다.
import dis

def add(a, b):
    return a + b

dis.dis(add)
Python 3.14에서는 대략 다음과 같은 명령을 확인할 수 있습니다.

구체적인 명령과 출력 형식은 Python 버전에 따라 달라질 수 있습니다. dis 모듈은 CPython Bytecode를 분석하기 위한 공식 도구이며 Python 3.11부터는 런타임 상황에 맞게 특화된 Bytecode도 확인할 수 있습니다.
각 명령을 개념적으로 해석하면 다음과 같습니다.
RESUME 0
함수 실행의 시작 지점을 나타내며 실제로 계산을 수행하는 opcode는 아니고 공식 문서상 no-op에 가깝습니다.
다만 tracing, debugging, optimization 같은 내부 처리를 위한 지점으로 사용됩니다.
여기서 0은 "일반 함수의 시작 지점" 이라는 의미입니다.
LOAD_FAST_BORROW_LOAD_FAST_BORROW 1 (a, b)
이름이 길지만 분해하면 LOAD_FAST_BORROW + LOAD_FAST_BORROW 입니다.
원래 개념적으로는 "a를 가져온다", "b를 가져온다" 라는 두 가지 작업이나 Python 3.14에서는 이를 하나의 opcode로 합쳐 실행할 수 있습니다.
BINARY_OP 0 (+)
두 객체에 "+ 연산 수행" 한다는 의미입니다.
RETURN_VALUE
"결과를 함수 호출자에게 반환" 한다는 의미입니다.
따라서 Python의 다음 한 줄도 실제로는 여러 Bytecode Instruction으로 분해되어 실행될 수 있습니다.
return a + b
여기서 한 가지 중요한 점은 CPU가 Python Bytecode를 직접 이해하는 것이 아니라는 것입니다.
CPU가 직접 실행하는 것은 CPython 자체를 구성하는 C 코드가 컴파일된 Machine Code(기계어)입니다.
따라서 구조를 조금 더 정확히 표현하면 다음과 같습니다.
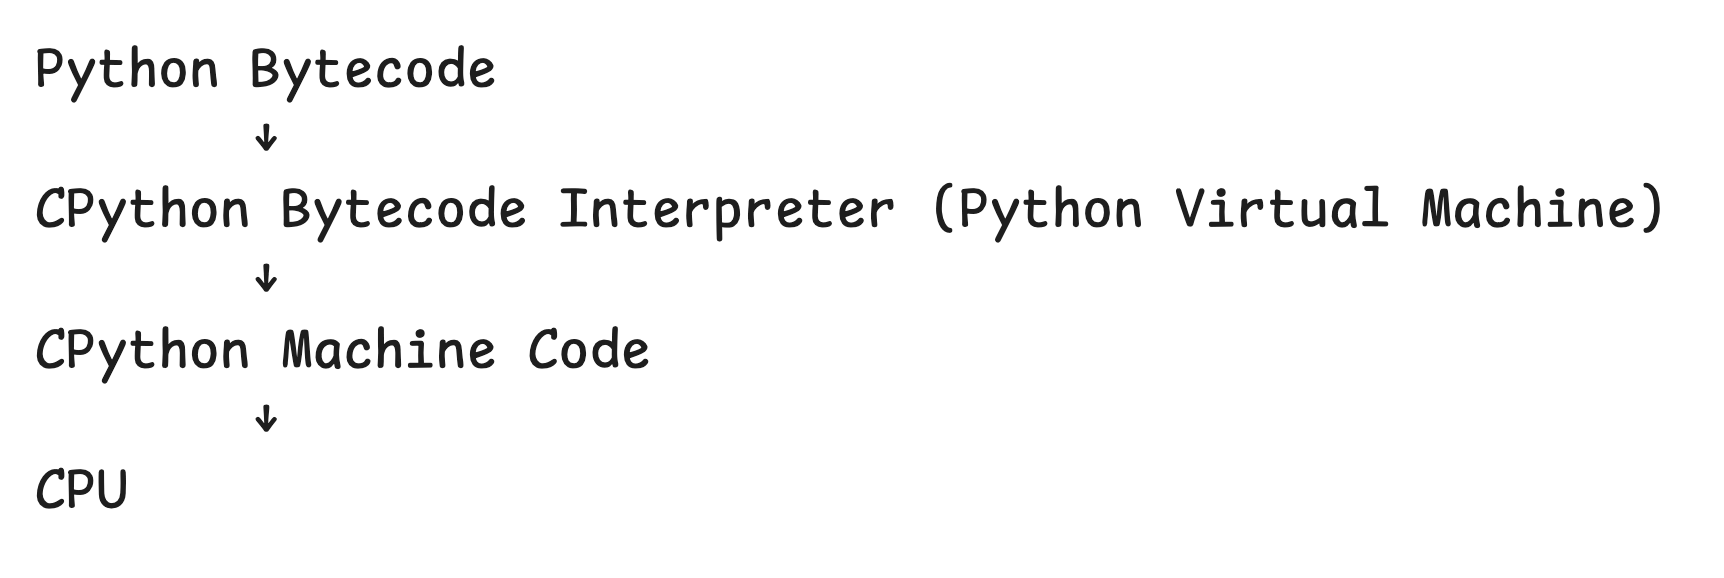
Python 공식 Glossary에서는 Python Virtual Machine이 Compiler가 생성한 Bytecode를 실행한다고 설명합니다.
Execution Frame
Bytecode만 있다고 해서 코드를 실행할 수 있는 것은 아닙니다.
예를 들어 다음 함수를 생각해보겠습니다.
def add(a, b):
    result = a + b
    return result
add()를 실행하려면 현재 a와 b가 어떤 객체를 가리키는지, 지역 변수 result는 무엇인지, 어떤 Code Object를 실행하고 있는지 등의 정보가 필요합니다.
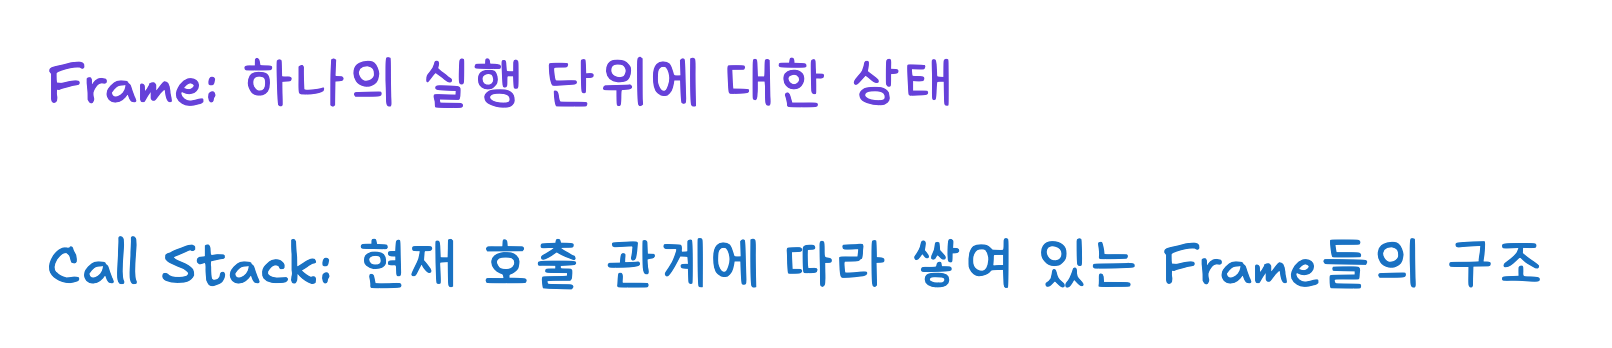
이러한 하나의 코드 실행에 필요한 상태를 관리하는 것이 Execution Frame입니다.
Python 공식 Execution Model에서는 Python 프로그램이 Code Block으로 구성되며 각 Code Block은 Execution Frame에서 실행된다고 설명합니다. 함수 body뿐만 아니라 module과 class definition 역시 Code Block에 해당합니다.
함수를 호출하면 개념적으로 다음과 같은 Frame이 만들어집니다.
add(10, 20)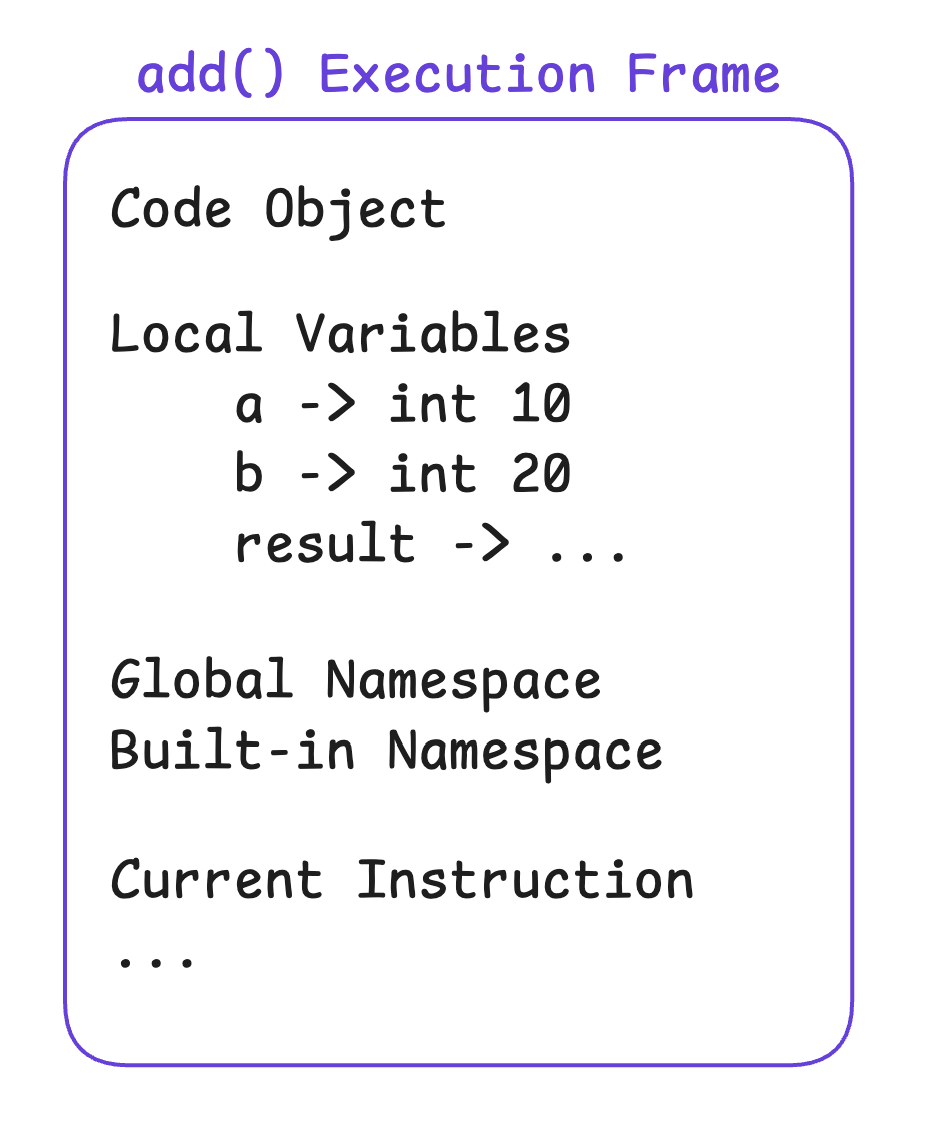
Python에서 실제로 노출되는 Frame Object에서도 이러한 정보 일부를 확인할 수 있습니다.
대표적으로 Frame에는 다음과 같은 정보가 있습니다.
import sys

frame = sys._getframe()

print("f_code     :", frame.f_code)		# 현재 실행 중인 Code Object
print("f_locals   :", frame.f_locals)		# Local Variable을 조회하기 위한 Mapping
print("f_globals  :", frame.f_globals)		# Global Namespace
print("f_builtins :", frame.f_builtins)		# Built-in Namespace
print("f_lasti    :", frame.f_lasti)		# 현재 실행 위치
print("f_back     :", frame.f_back)		# 이전 Stack Frame
앞서 Object Model에서 살펴본 이름과 객체의 Binding이 실제 코드 실행 시 Frame의 실행 Context 안에서 사용되는 것입니다.
Call Stack
Frame 하나는 하나의 코드 실행 상태를 나타내며 함수 안에서 또 다른 함수를 호출하면 새로운 Frame이 필요합니다.
def foo():
    bar()

def bar():
    baz()

def baz():
    pass

foo()
baz()가 실행되는 순간을 생각해보면 다음과 같은 구조가 됩니다.
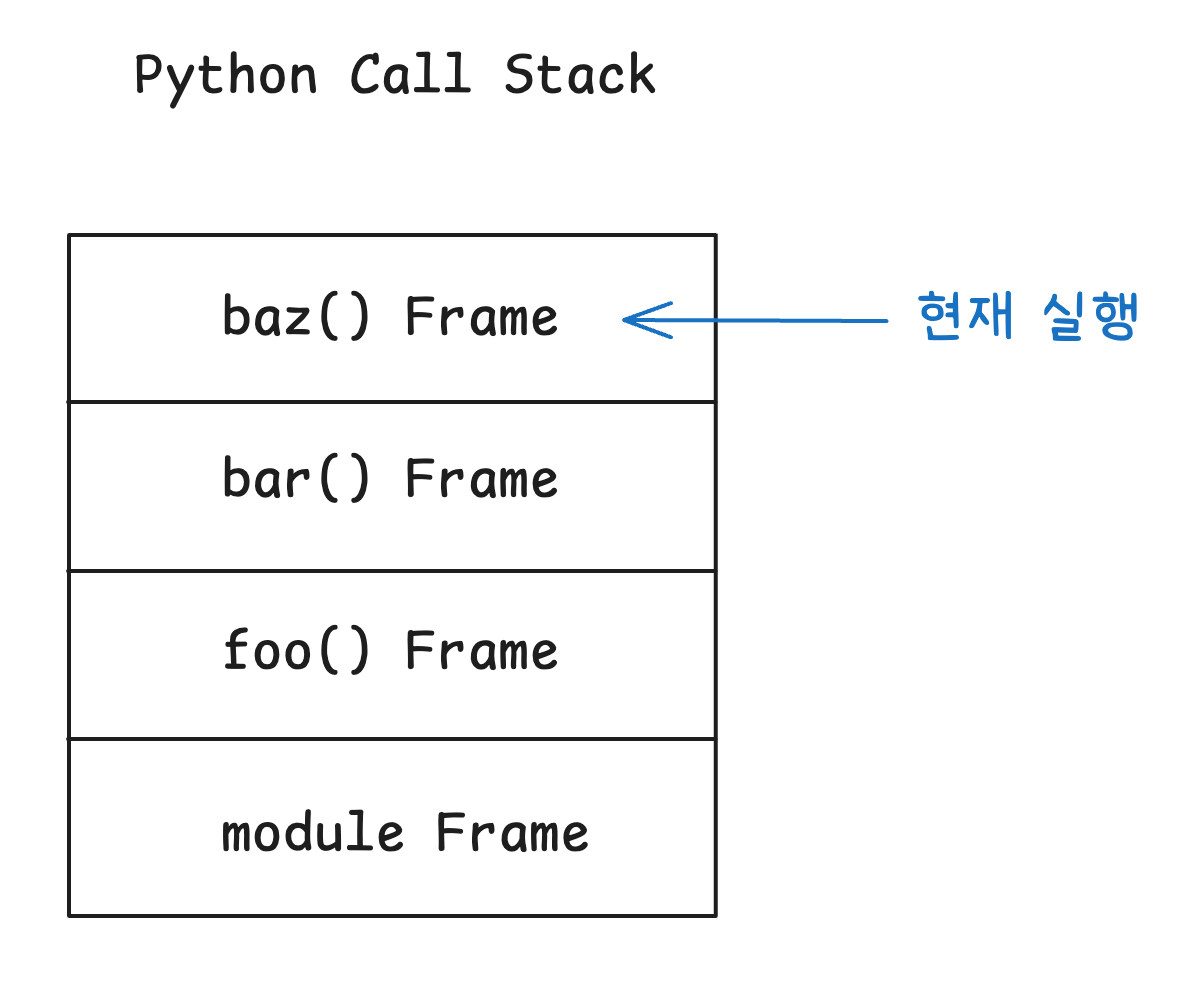
이처럼 Frame들이 함수 호출 순서에 따라 쌓인 구조를 Call Stack이라고 볼 수 있습니다.
또한 하나의 함수가 항상 하나의 Frame만 가지는 것도 아닙니다.
def recursive(n):
    if n > 0:
        recursive(n - 1)

recursive(2)
위 코드 실행 중에는 같은 함수에 대한 Frame이 여러 개 존재할 수 있습니다.
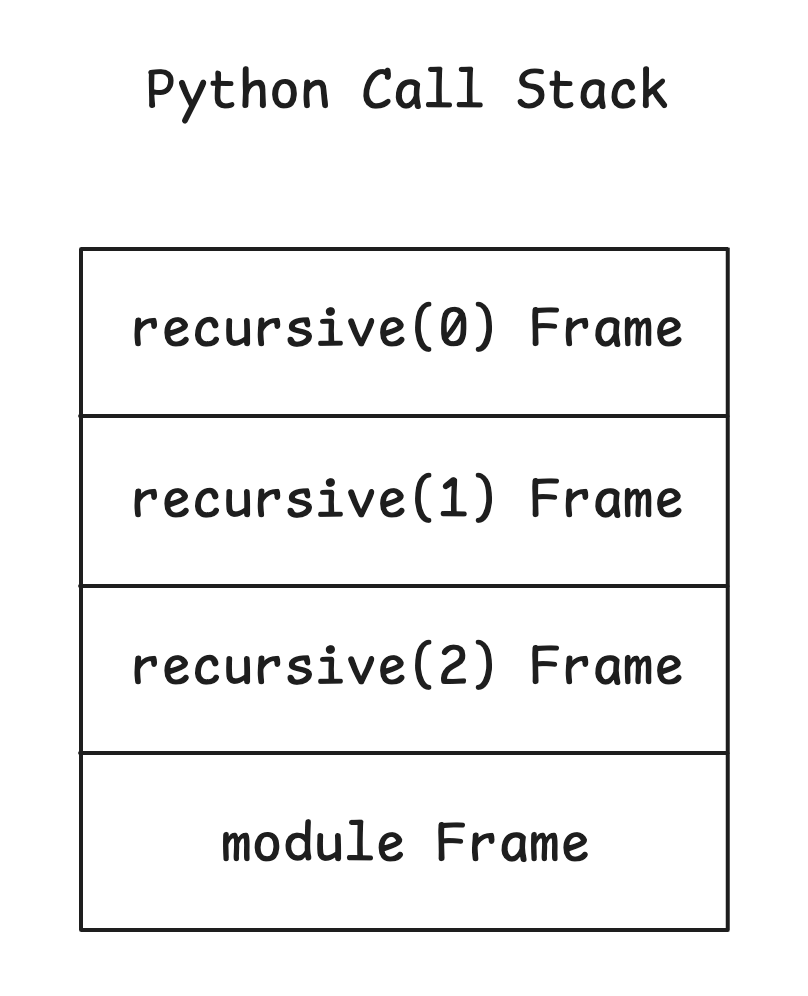
즉 정확하게는 함수 하나당 Frame 하나가 아니라, 함수 호출 한 번마다 독립적인 Execution Frame이 필요합니다.
Frame의 f_back은 호출자 방향의 이전 Stack Frame을 가리키며 이를 통해 Frame 간의 호출 관계도 표현할 수 있습니다.
Bytecode Interpreter
이제 실행에 필요한 요소가 준비되었습니다.
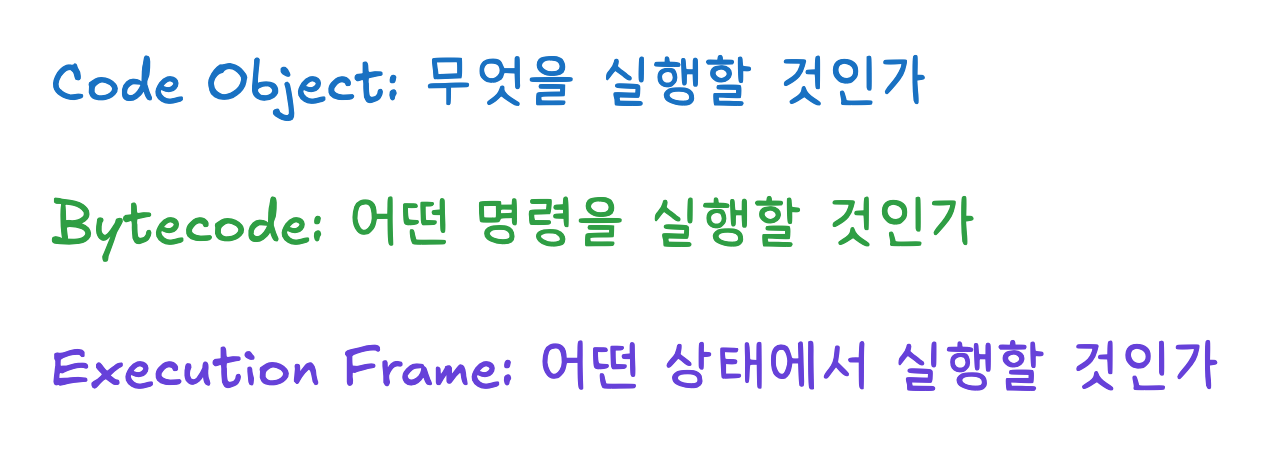
이 Bytecode를 실제로 읽고 실행하는 것이 Bytecode Interpreter입니다.
개념적으로 다음과 같은 작업을 반복합니다.
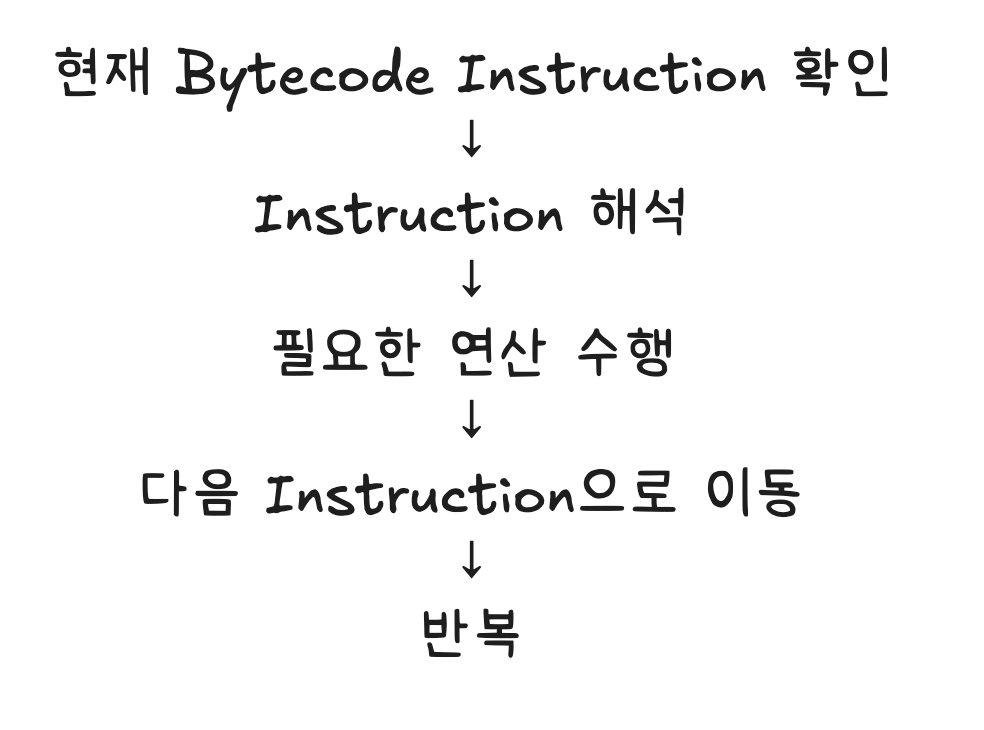
이것이 Python에서 말하는 Python Virtual Machine과 연결됩니다.
Python 공식 Glossary는 Virtual Machine을 소프트웨어로 정의된 컴퓨터로 설명하며 Python Virtual Machine은 Bytecode Compiler가 생성한 Bytecode를 실행한다고 설명합니다.
따라서 다음과 같이 구분할 수 있습니다.
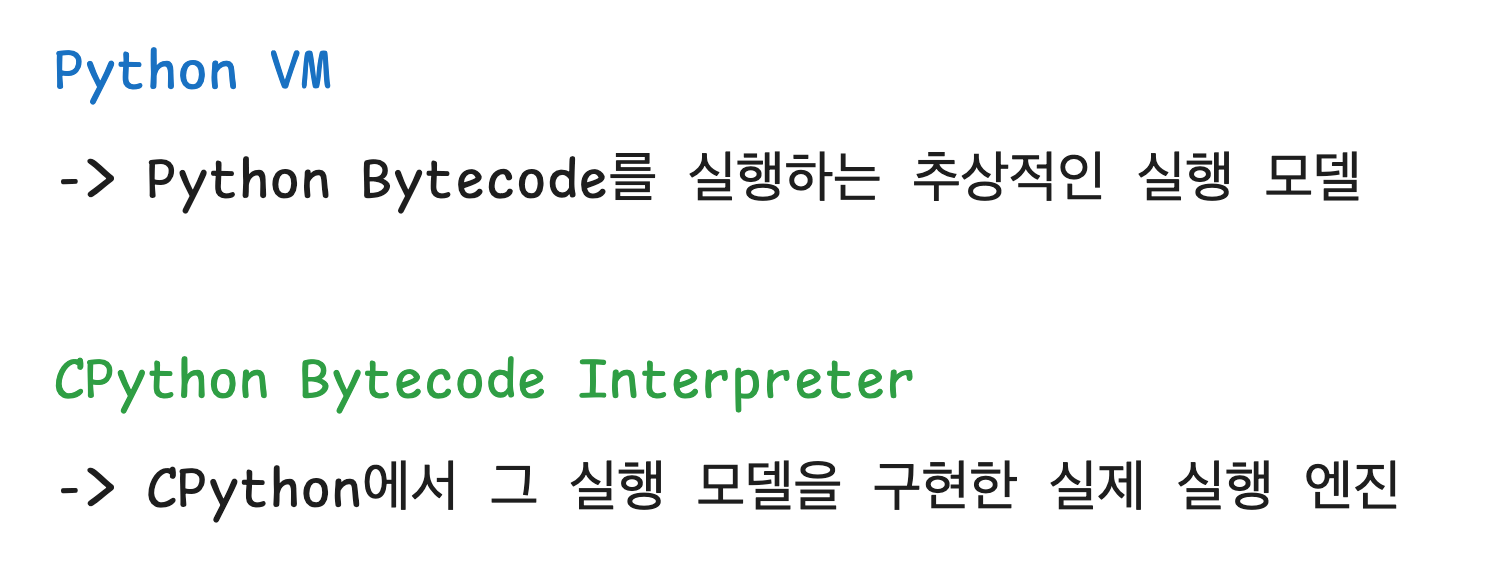
즉 일상적으로는 둘을 비슷한 의미로 이야기할 수 있지만 엄밀하게는 VM은 추상적인 실행 머신이고 Bytecode Interpreter는 CPython의 구체적인 구현이라고 보는 것이 좋습니다.
전체 흐름을 다시 보면 다음과 같습니다.
CPython Runtime
여기에서 마지막으로 구분해야 하는 용어가 CPython, Interpreter, Runtime입니다.
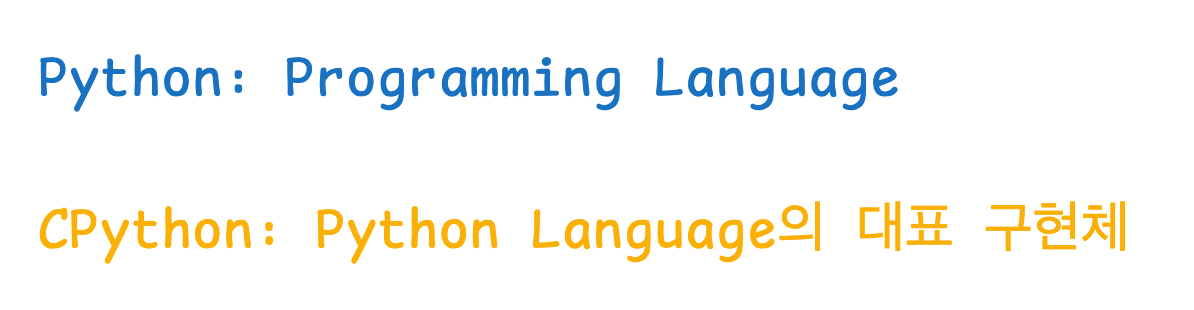
Python 자체는 프로그래밍 언어입니다.
반면 CPython은 Python 언어의 대표적인 구현체입니다.
Python 공식 Glossary에서는 CPython을 python.org에서 배포하는 Python의 canonical implementation으로 정의하며 Jython이나 IronPython과 같은 다른 구현체와 구분할 때 사용하는 이름이라고 설명합니다.
CPython 안에는 단순히 Bytecode Interpreter만 존재하는 것이 아닙니다.
개념적으로 다음과 같은 여러 구성 요소가 함께 동작합니다.
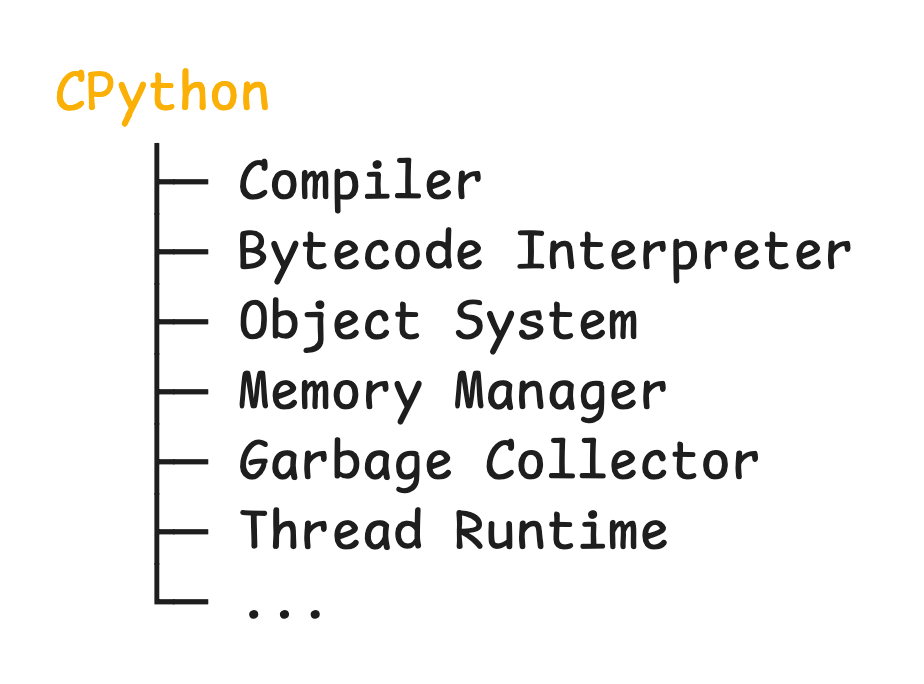
이러한 구성 요소들이 프로그램 실행 중 동작하는 전체 환경을 CPython Runtime이라고 이해할 수 있습니다.
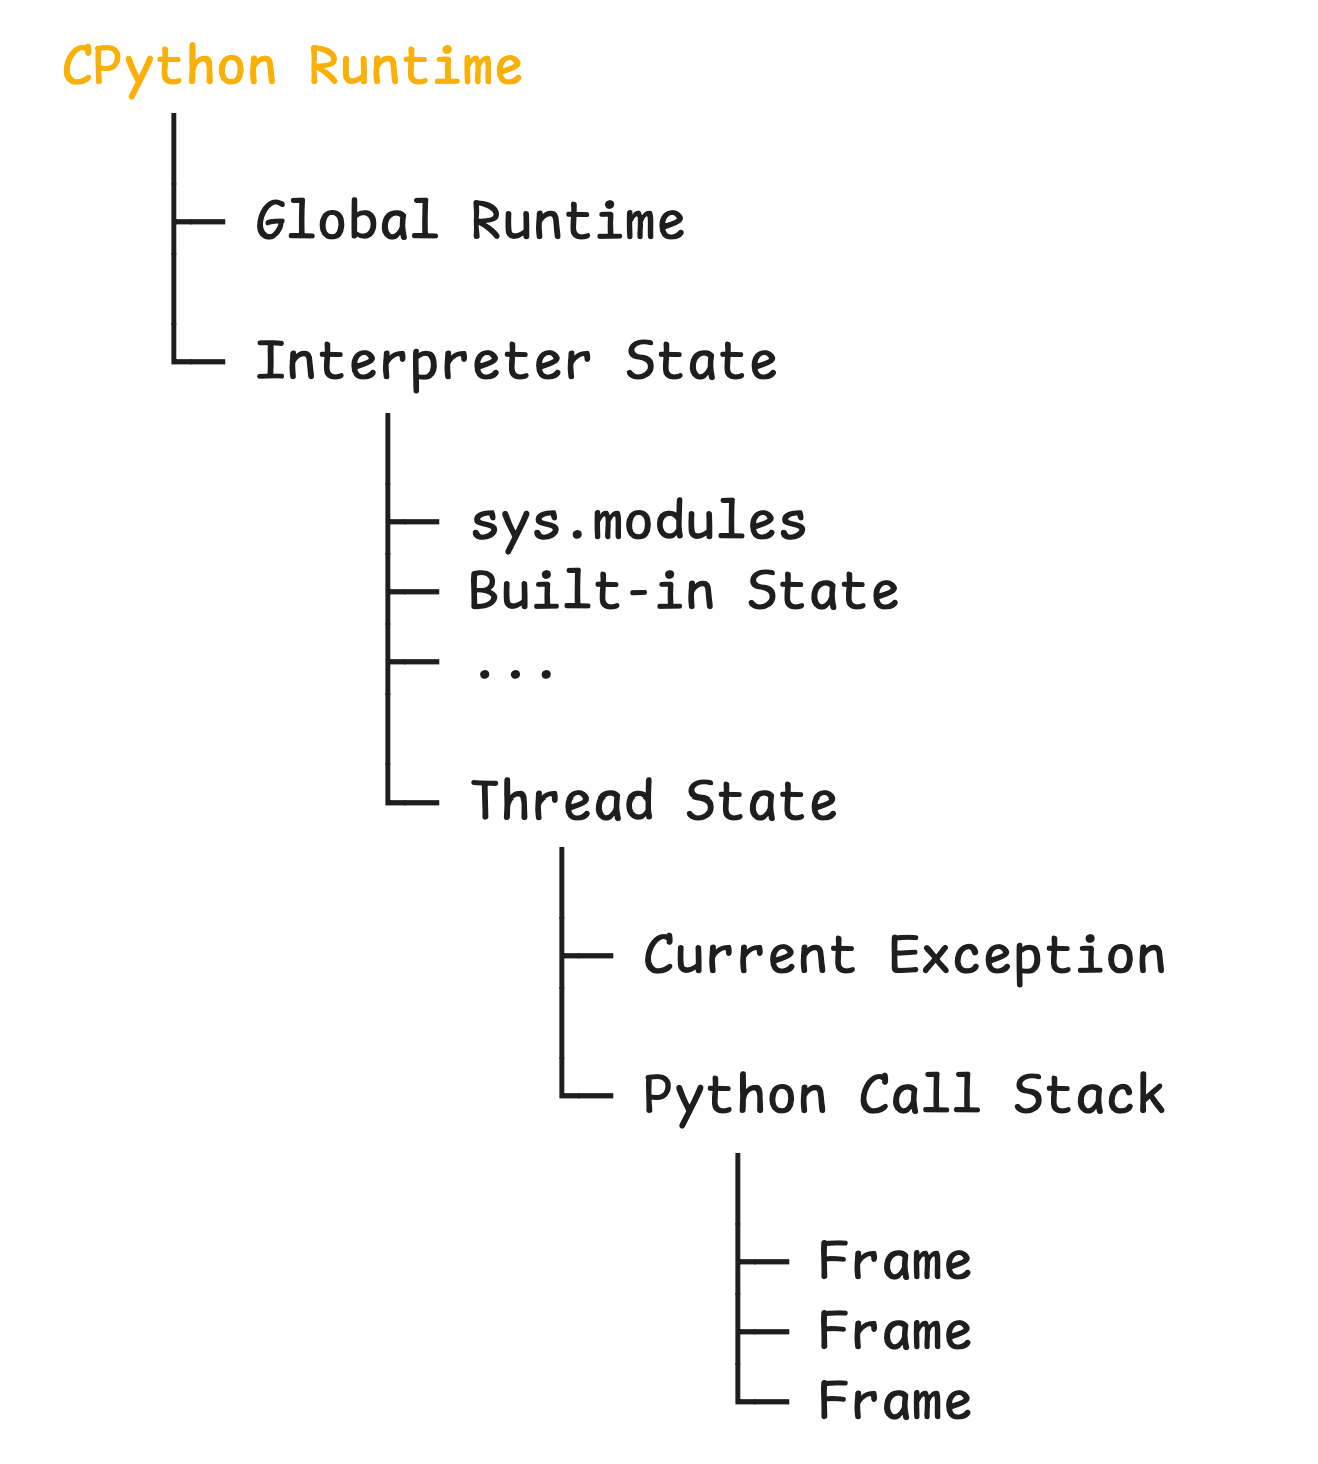
Python 3.14 공식 Execution Model에서는 Python Runtime을 보다 구체적으로 다음과 같은 계층으로 설명합니다.
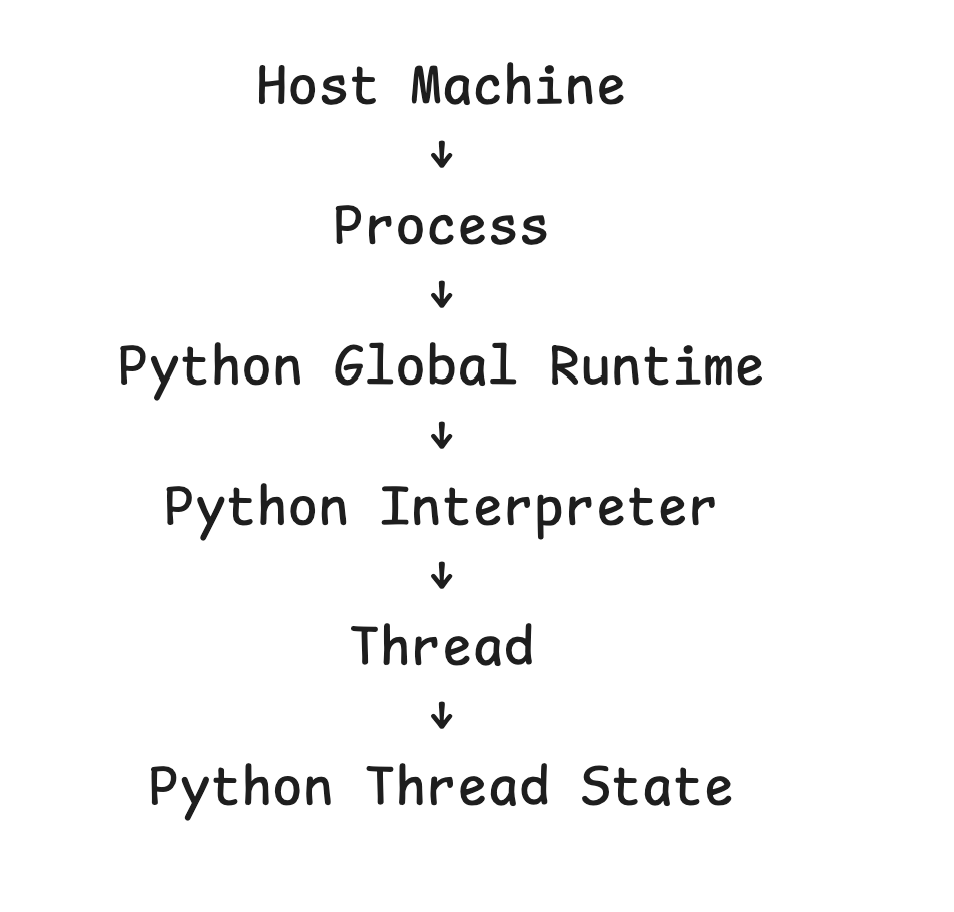
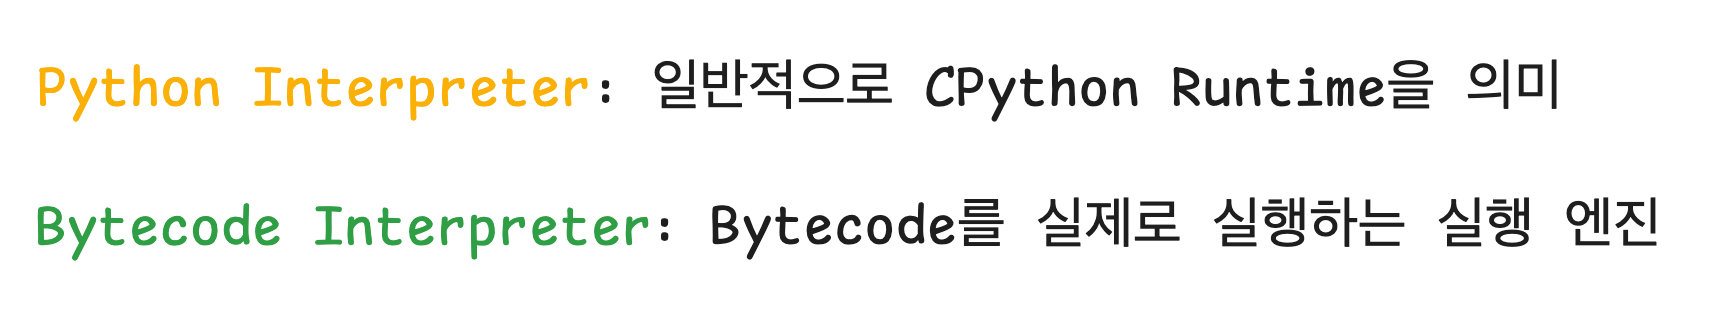
여기서 Interpreter라는 용어가 다시 등장하기 때문에 주의가 필요합니다.
공식 문서는 이 Interpreter를 Bytecode Interpreter와 명확하게 구분합니다.
Runtime Model에서의 Interpreter는 하나의 Python 실행 환경에 필요한 상태를 보관하는 단위입니다.
예를 들어 Interpreter State에는 sys.modules와 같이 해당 Interpreter가 유지해야 하는 상태가 포함됩니다. 하나의 Process 안에 여러 Interpreter가 존재하는 것도 가능합니다.
반면 Thread별 실행 상태는 Thread State가 관리합니다.
Thread State에는 현재 발생한 Exception이나 해당 Thread의 Python Call Stack처럼 Thread마다 독립적으로 필요한 실행 상태가 포함됩니다.
따라서 개념적으로 다음과 같이 볼 수 있습니다.
이 구조를 알면 흔히 사용하는 Python Interpreter라는 표현도 조금 더 정확하게 구분할 수 있습니다.
마치며
CPython은 Python 소스 코드를 Bytecode로 컴파일하고 실행에 필요한 상태를 Frame에 구성한 뒤 Bytecode Interpreter를 통해 이를 실행합니다. 그리고 여러 Frame은 호출 관계에 따라 Call Stack을 구성하며 Bytecode Interpreter는 현재 Frame과 Thread State를 이용해 Python 코드를 실행합니다.
다음 글에서는 Memory Management를 중심으로 Python 객체의 메모리가 어떻게 할당되고, Reference Counting과 Garbage Collection을 통해 어떻게 관리되는지 살펴보겠습니다.
참고 문서
'Lang > Python' 카테고리의 다른 글
| [Python] (5) Memory Management (0) | 2026.09.26 |
|---|---|
| [Python] (4) Data Model (0) | 2026.09.26 |
| [Python] (2) Object Model (0) | 2026.09.21 |
| [Python] (1) GIL (0) | 2026.09.21 |
| Python (4) - 내장 함수, 표준 라이브러리, 외부 라이브러리 (2) | 2025.05.18 |