Object Model
Python의 변수를 처음 배울 때 다음과 같은 코드를 흔히 "a라는 변수에 10이라는 값을 저장한다"고 설명합니다.
a = 10
입문 단계에서는 충분히 직관적인 설명이지만, Python의 동작 방식을 조금 더 깊게 이해하려면 다른 관점이 필요합니다.
Java에서는 다음과 같이 primitive 값을 지역 변수에 직접 저장할 수 있습니다.
int a = 10;
반면 Python에는 Java의 int, boolean, double과 같은 의미의 primitive type이 존재하지 않습니다. 10 역시 하나의 객체이며 a는 해당 객체와 연결된 이름입니다.
따라서 Python의 변수와 메모리 동작을 이해하기 위해서는 먼저 Object, Name, Binding, Namespace, Scope의 관계를 이해할 필요가 있습니다.
Object
Python에서 데이터는 객체(Object)를 중심으로 표현됩니다.
Python 공식 Data Model은 다음과 같이 설명합니다.
Python 프로그램의 모든 데이터는 객체 또는 객체 간의 관계로 표현됩니다. 코드 역시 객체로 표현됩니다.
따라서 다음의 값들은 모두 객체입니다.
10
3.14
True
"Python"
[1, 2, 3]
{"name": "Python"}
정수뿐만 아니라 문자열, 리스트, 딕셔너리도 객체이며 함수와 클래스 역시 마찬가지입니다.
def hello():
    pass

class User:
    pass
hello는 함수 객체이고 User는 클래스 객체입니다.
이는 Java와 비교했을 때 중요한 차이입니다.
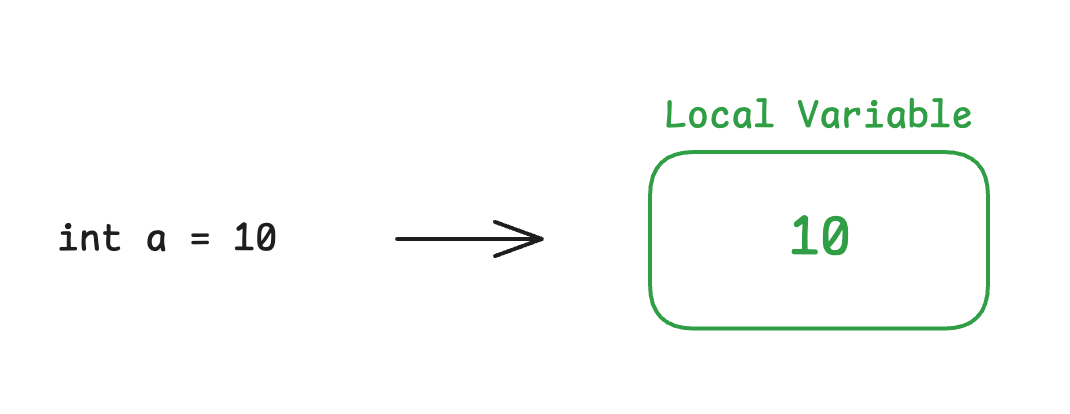
Java에서는 자료형을 크게 primitive type과 reference type으로 구분할 수 있습니다.
int a = 10;
Integer b = 10;
개념적으로 보면 다음과 같습니다.
반면 객체를 사용하는 경우에는 객체에 대한 reference를 저장합니다.
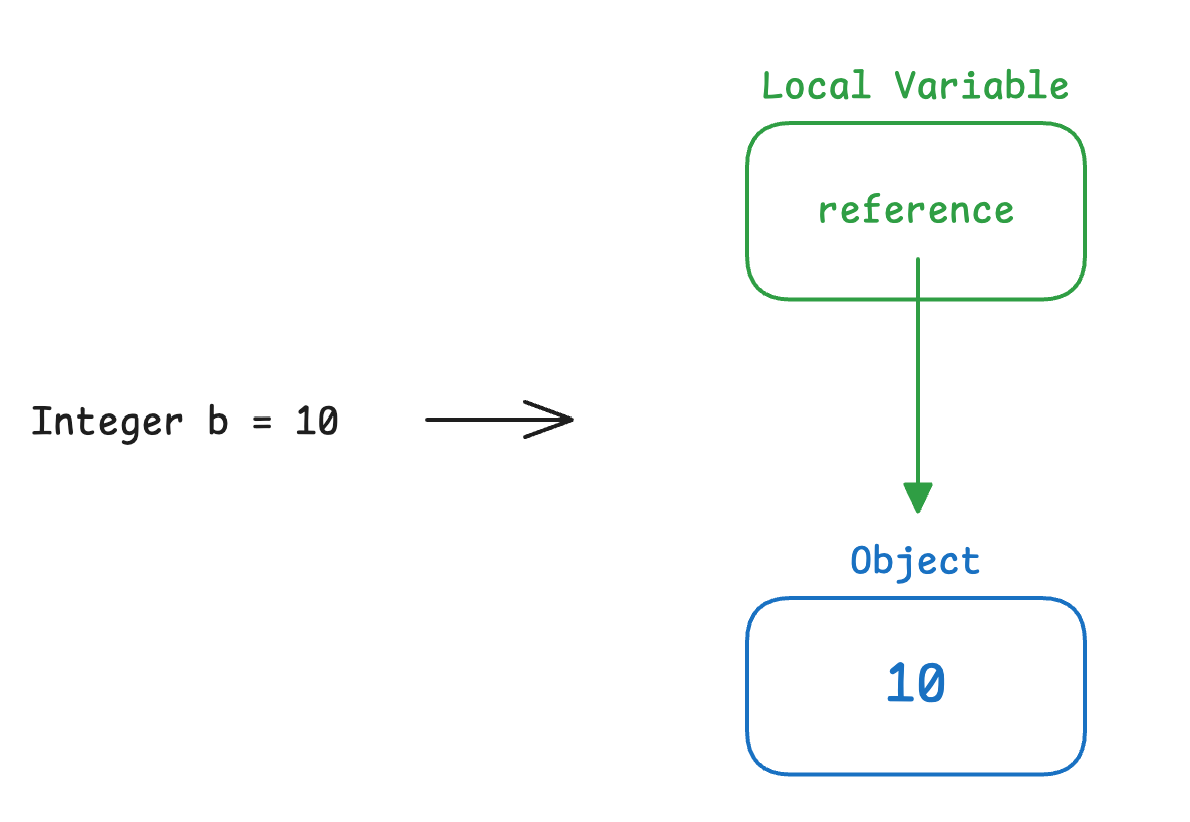
Python에는 첫 번째 경우에 해당하는 언어 수준의 primitive variable이 없습니다.
a = 10
위 코드를 파이썬은 개념적으로 다음과 같이 바라볼 수 있습니다.
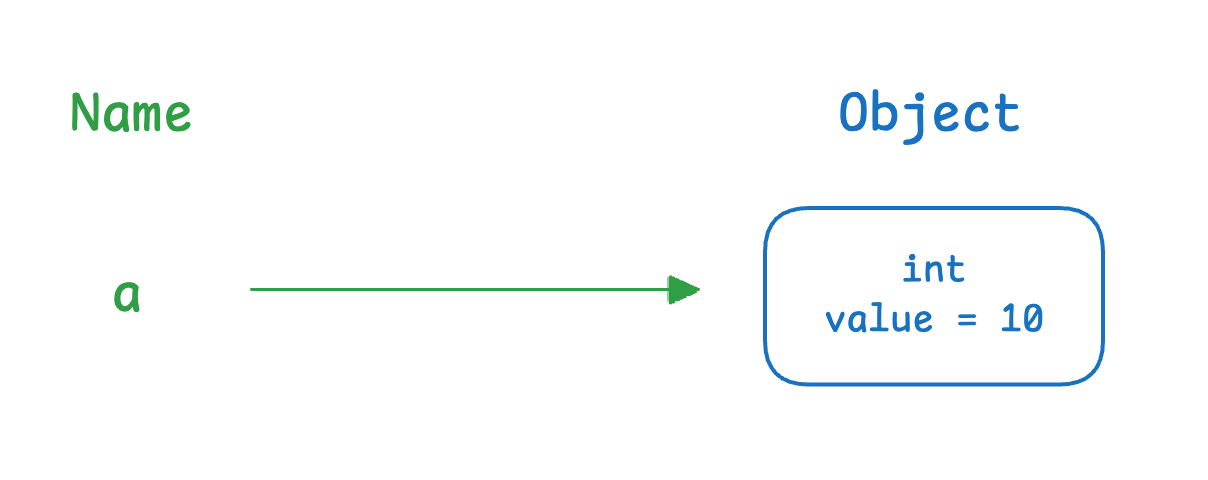
즉 Python에서는 10이라는 데이터 역시 객체로 표현됩니다.
다만 여기서 a를 곧바로 C나 Java의 pointer 변수와 동일하다고 이해할 필요는 없습니다.
Python 언어 수준에서는 이름(Name)이 객체(Object)를 가리킨다고 표현하는 것이 가장 정확합니다.
Identity, Type, Value
Python 공식 Data Model에 따르면 모든 객체는 세 가지 특성을 가집니다.
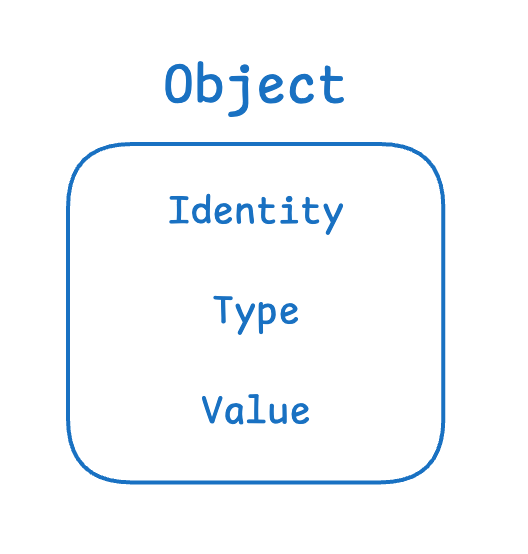
객체가 생성되면 identity와 type은 변경되지 않으며 value의 변경 가능 여부는 객체의 type에 따라 달라집니다.
Identity
Identity는 객체 자체를 다른 객체와 구분하는 정체성입니다.
Python에서는 id()를 이용해 객체의 identity를 나타내는 정수를 확인할 수 있습니다.
a = [1, 2, 3]

print(id(a))
# 4312323040
CPython에서는 id()가 반환하는 값으로 실제 객체의 메모리 주소를 사용합니다.
또한 is 연산자를 사용하면 두 이름이 동일한 객체를 가리키는지 확인할 수 있습니다.
a = [1, 2, 3]
b = a

print(a is b)
# True
a와 b가 동일한 리스트 객체를 가리키기 때문에 True를 반환합니다.
Type
Type은 객체가 어떤 종류의 객체인지 나타냅니다.
a = 10

print(type(a))
# <class 'int'>
a가 가리키는 객체는 int 타입의 인스턴스라는 의미입니다.
객체의 type은 단순히 객체를 분류하기 위한 정보만은 아닙니다.
어떤 연산을 지원하는지와 해당 객체가 어떤 값을 가질 수 있는지도 type에 의해 결정됩니다.
예를 들어 리스트에는 길이(length)라는 개념이 존재합니다.
len([1, 2, 3])
하지만 정수에는 길이라는 개념이 없기 때문에 TypeError가 발생합니다.
print(len(10))
# TypeError: object of type 'int' has no len()
여기서 type()이 반환하는 int, list와 같은 type 자체도 다시 Python 객체입니다.
즉 Python의 객체 모델에서는 타입 역시 객체입니다.
Value
Value는 해당 객체가 나타내는 값입니다.
a = 10
a가 가리키는 int 객체의 값은 10입니다.
b = [10, 20]
b가 가리키는 리스트 객체의 값은 [10, 20]입니다.
다만 모든 객체의 값이 동일한 방식으로 다뤄지는 것은 아닙니다.
어떤 객체는 생성 이후 값을 변경할 수 있고, 어떤 객체는 그렇지 않습니다.
이는 뒤에서 살펴볼 Mutable과 Immutable의 차이로 이어집니다.
Identity & Equality
Python의 모든 Object는 Identity, Type, Value를 가집니다.
이 중 Identity와 Value의 차이는 is와 == 연산에서 명확하게 드러납니다.
a = [1, 2]
b = [1, 2]

print(a is b)  # False
print(a == b)  # True
a와 b는 같은 내용을 가지고 있지만 서로 다른 Object입니다.
is는 두 Reference가 동일한 Object를 가리키는지, 즉 Identity가 같은지를 확인합니다.
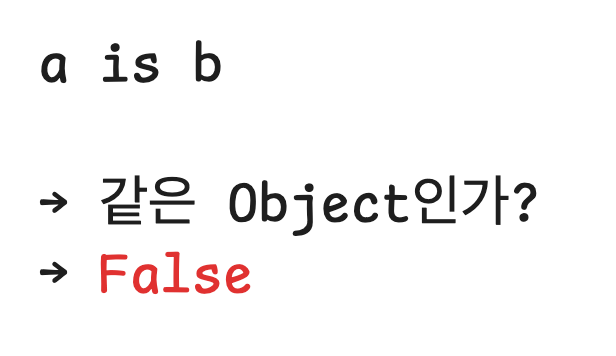
이때 is가 내부적으로 id()를 호출해 두 정수 값을 비교하는 것은 아닙니다.
반면 ==는 두 Object가 동등한 것으로 정의되어 있는지를 확인합니다.
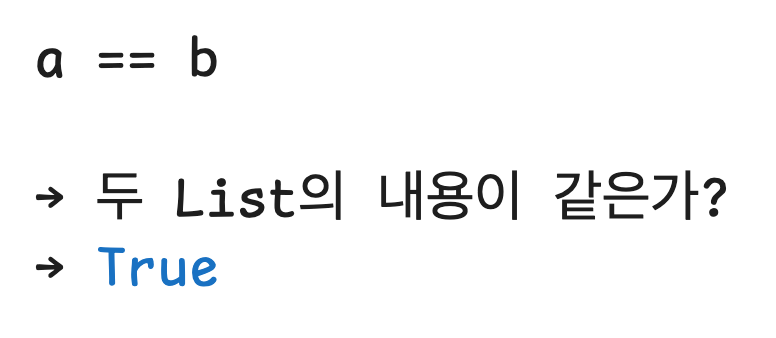
이때 ==가 어떤 상태를 같다고 볼지는 각 Type이 정의할 수 있으며, Equality가 Type에 의해 어떻게 정의되는지는 이후 Data Model에서 살펴보겠습니다.
Name Binding
Python에서 흔히 변수라고 부르는 것은 보다 정확하게는 이름(Name)의 관점에서 이해할 수 있습니다.
Python 공식 Execution Model에서는 이를 명확하게 다음과 같이 표현합니다.
Names refer to objects.
또한 이름은 Name Binding Operation을 통해 객체와 연결됩니다.
a = 10
따라서 위 표현은 "a라는 메모리 공간에 10을 넣는다"기보다 다음과 같이 이해할 수 있습니다.
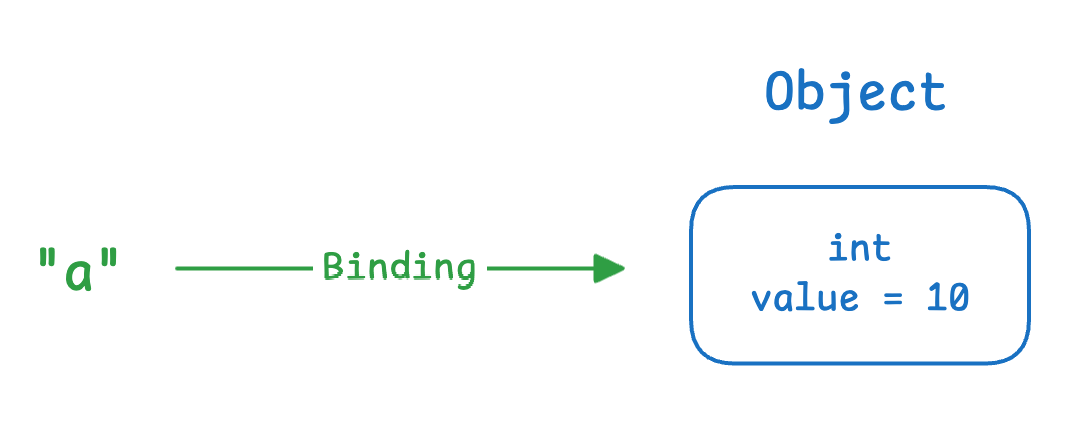
여기에서 중요한 점은 10 객체 내부에 "a"라는 이름이 저장되는 것이 아니라는 것입니다.
객체는 자신이 어떤 이름으로 참조되고 있는지 알 필요가 없습니다.
예를 들어 다음을 실행하면 새로운 리스트가 만들어지는 것이 아닙니다.
a = [1, 2, 3]
b = a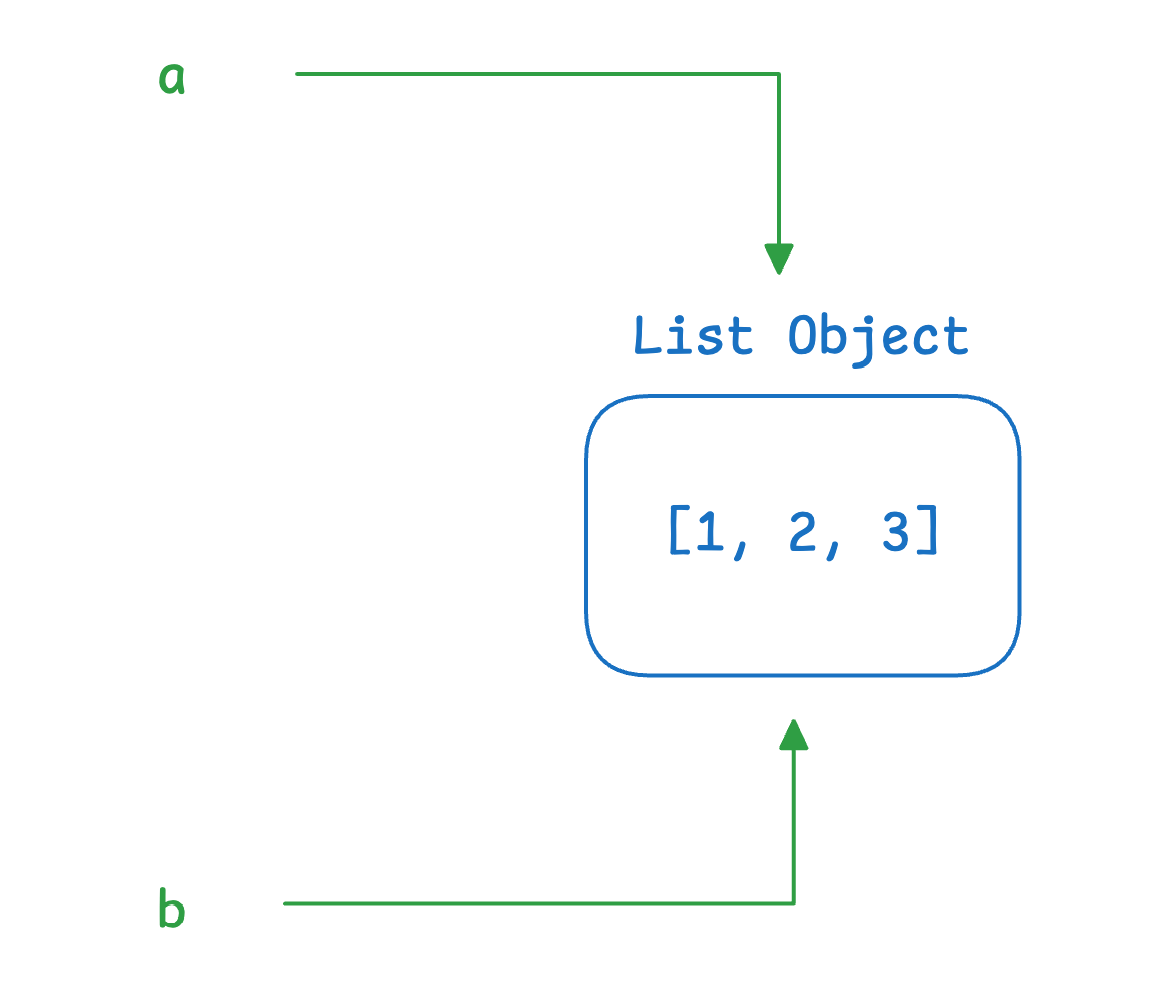
a와 b라는 서로 다른 이름이 동일한 객체에 바인딩됩니다.
a is b따라서 위의 결과는 True입니다.
대입문은 객체를 복사하는 연산이 아닙니다.
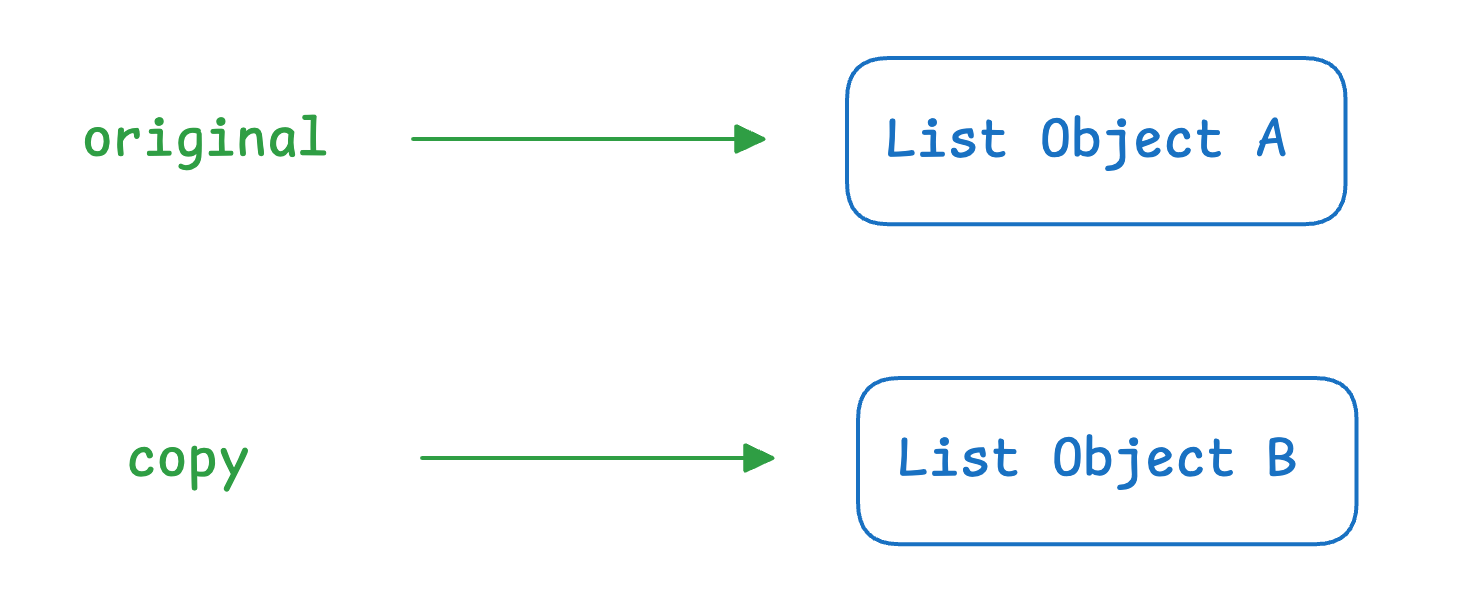
별도의 리스트 객체를 만들고 싶다면 명시적인 복사가 필요합니다.
original = [1, 2, 3]
copy = original.copy()
이 경우에는 두 이름이 서로 다른 객체를 가리키게 됩니다.
Name Binding은 단순한 대입문에서만 발생하지 않습니다.
Python 공식 Execution Model에서는 다음과 같은 여러 구문이 이름을 바인딩한다고 설명합니다.
# 대입은 a라는 이름을 객체에 바인딩
a = 10

# 함수 정의는 hello라는 이름을 생성된 함수 객체에 바인딩
def hello():
    pass

# 클래스 정의는 User라는 이름을 생성된 클래스 객체에 바인딩
class User:
    pass

# import는 json이라는 이름을 module 객체와 바인딩
import json
그리고 함수의 parameter 또한 함수 호출 시 전달된 객체와 이름을 바인딩합니다.
Namespace
이름과 객체의 Binding을 관리하기 위해서는 이러한 관계를 저장할 공간이 필요한데 이를 Namespace라고 합니다.
즉, Namespace는 Name과 Object 사이의 Binding을 관리하는 공간이라고 이해할 수 있습니다.
Namespace를 단순히 하나의 dict라고 생각하는 경우도 있지만 둘을 완전히 동일한 개념으로 보는 것은 정확하지 않습니다.
예를 들어 모듈의 Global Namespace는 실제로 dictionary 형태로 확인할 수 있습니다.
a = 10

print(globals())
globals()는 현재 모듈의 global namespace를 나타내는 dictionary를 반환합니다.
따라서 개념적으로는 다음과 같습니다.
Global Namespace

{
    "a": int object 10
}
하지만 모든 Namespace가 내부적으로 항상 동일한 dictionary 구조를 이용하는 것은 아닙니다.
CPython은 함수의 지역 변수를 효율적으로 처리하기 위해 최적화된 별도 저장 구조를 사용할 수 있습니다.
Python에는 하나의 Namespace만 존재하는 것이 아니며 대표적으로 다음과 같은 Namespace를 생각할 수 있습니다.
Local Namespace

Enclosing Namespace

Global Namespace

Built-in Namespace
여기에서 print, len, type, id와 같은 이름은 Built-in Namespace에서 제공됩니다.
여기서 주의할 점은 Local, Enclosing, Global, Built-in이 Python에 존재하는 Namespace의 전체 종류를 의미하는 것은 아니라는 점입니다. 이 네 가지는 일반적인 이름을 조회할 때 사용하는 LEGB Scope 검색 순서를 설명하기 위한 구분일 뿐 Python에는 이외에도 Class Namespace, Module Namespace, Instance Attribute Namespace 등 다양한 Namespace가 존재할 수 있습니다.
Python에는 builtins라는 모듈이 존재하며, Python의 built-in identifier에 직접 접근할 수 있도록 합니다.
예를 들어 다음과 같이 사용할 수도 있습니다.
import builtins

builtins.print("Hello")
그러나 일반적으로는 builtins를 명시적으로 import하지 않아도 Built-in Namespace가 이름 검색 과정에 기본적으로 포함되어 있기 때문에 다음처럼 바로 사용할 수 있습니다.
print("Hello")
Scope
Namespace와 함께 알아야 하는 개념이 Scope입니다.
두 용어가 비슷해 보이지만 의미는 다릅니다.
Namespace가 "어떤 이름이 어떤 객체와 Binding되어 있는가?" 를 다룬다면,
Scope는 "현재 코드에서 어떤 이름을 사용할 수 있는가?" 를 다룹니다.
Python 공식 Execution Model에서는 Scope를 코드 블록에서 이름의 visibility를 정의하는 것으로 설명합니다.
x = "global"

def outer():
    y = "enclosing"

    def inner():
        z = "local"
        print(z)

    inner()
예를 들어 위 코드에서 각 이름은 서로 다른 Scope에 존재합니다.

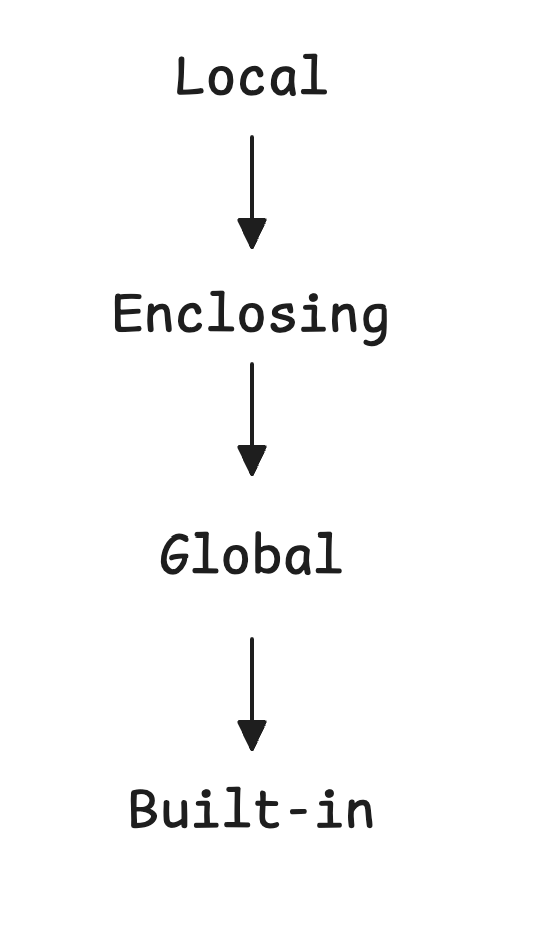
Python에서 이름을 사용할 때는 현재 위치에서 접근할 수 있는 Scope를 기준으로 이름을 찾습니다.
일반적으로 이를 LEGB Rule이라고 설명합니다.
예를 들어
x = "global"

def outer():
    x = "enclosing"

    def inner():
        x = "local"
        print(x)

    inner()

outer()
inner() 내부에서 x를 찾으면 가장 가까운 Local Scope에 x가 존재하므로 local이 출력됩니다.
local
Local Scope에 없다면 Enclosing Scope를 찾고 이후 Global, Built-in 순서로 이름을 탐색합니다.
어떤 Scope에서도 해당 이름을 찾지 못하면 NameError가 발생합니다.
Mutable & Immutable
객체 모델에서 마지막으로 중요한 개념은 Mutability입니다.
Python 객체는 생성된 이후 자신의 값을 변경할 수 있는지에 따라 크게 Mutable과 Immutable로 나눌 수 있습니다.
공식 Data Model에서는 숫자, 문자열, 튜플 등을 Immutable 객체로, 리스트와 딕셔너리 등을 Mutable 객체로 설명합니다.
Immutable
대표적인 Immutable 타입에는 다음과 같은 것들이 있습니다.
int
float
bool
str
tuple
예를 들어
a = 10
b = a

a = 20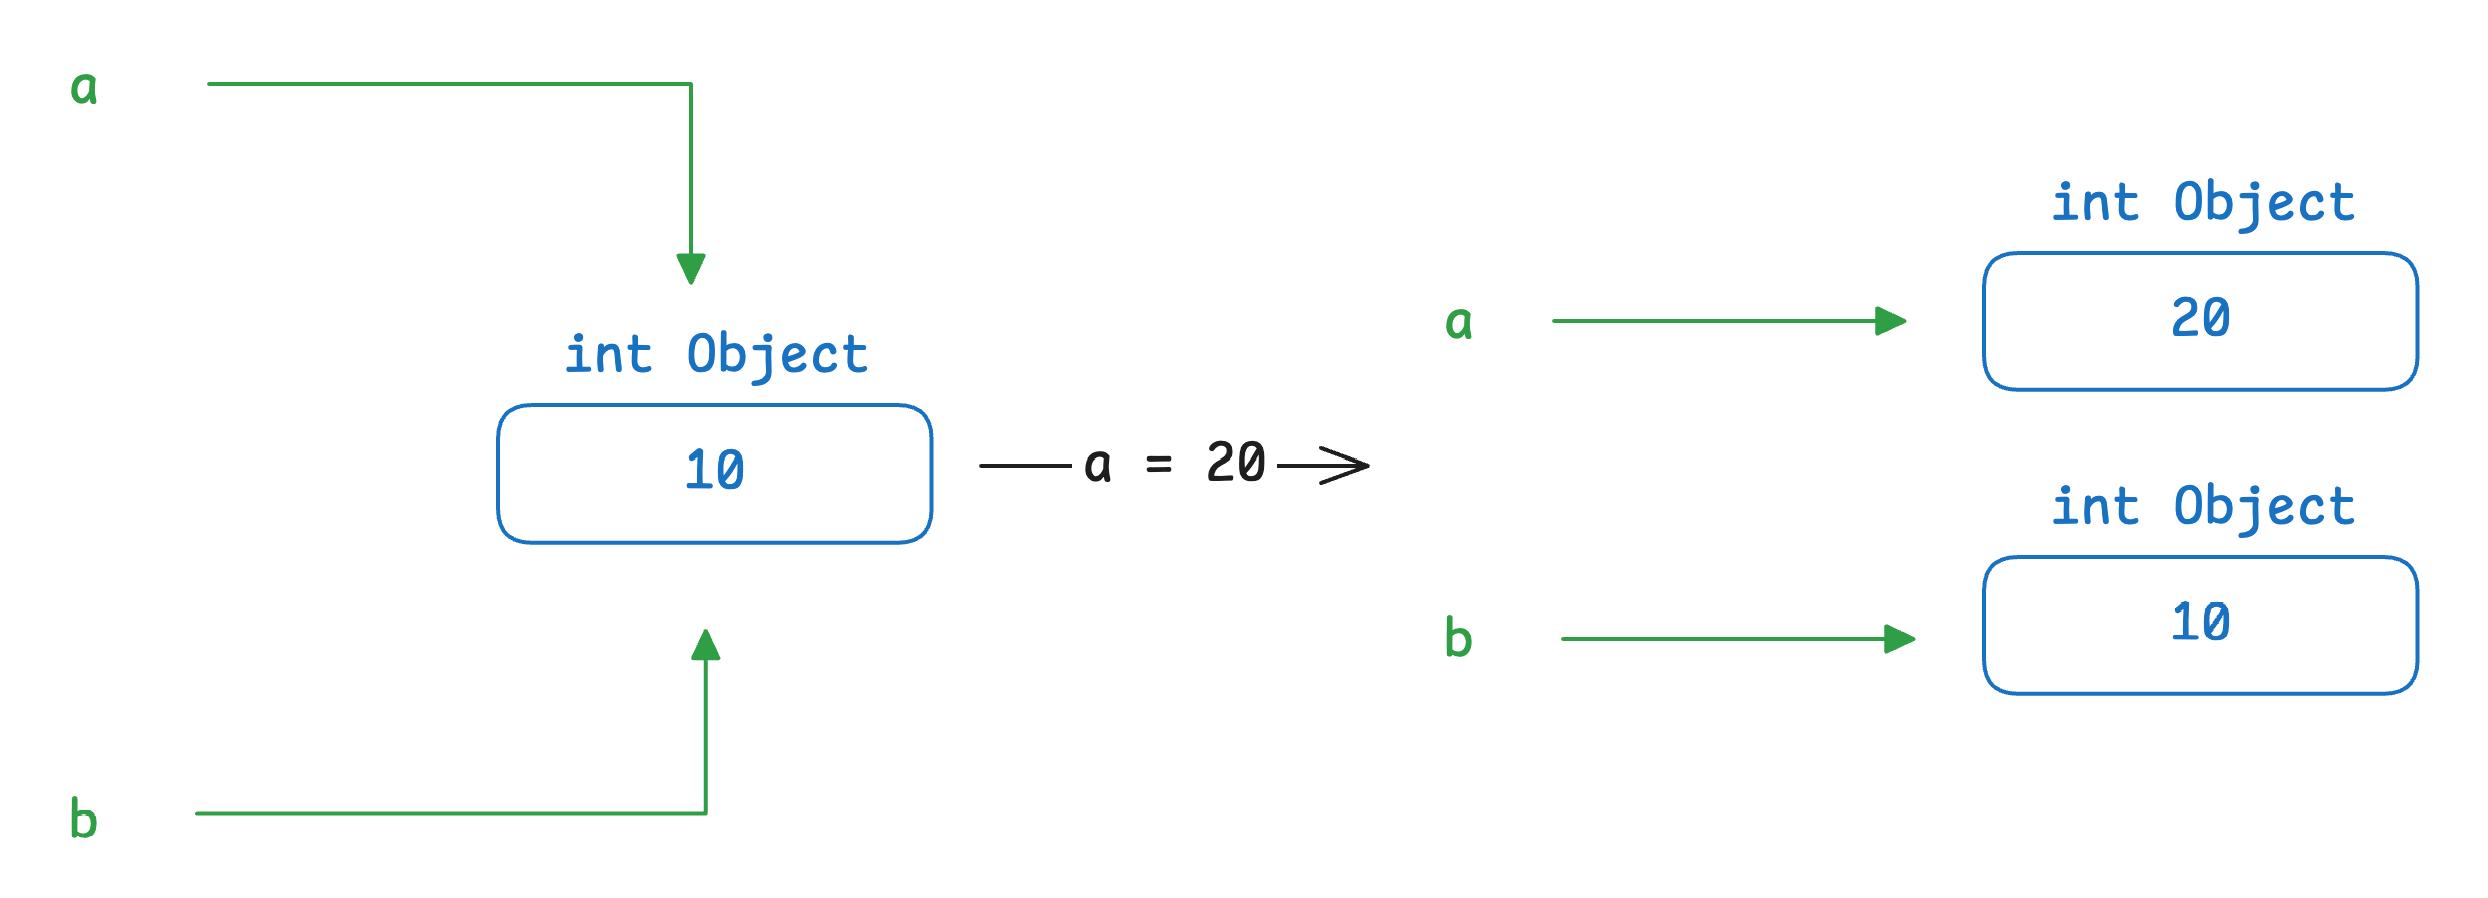
기존 10 객체가 20으로 변하는 것이 아닌 a가 새로운 객체와 다시 Binding된 것입니다.
int 객체는 Immutable이므로 기존 객체의 value인 10 자체를 20으로 변경하지 않습니다.
Mutable
반면 리스트는 Mutable 객체입니다.
a = [1, 2, 3]
b = a

b.append(4)
a와 b는 같은 객체에 바인딩되어 있습니다.
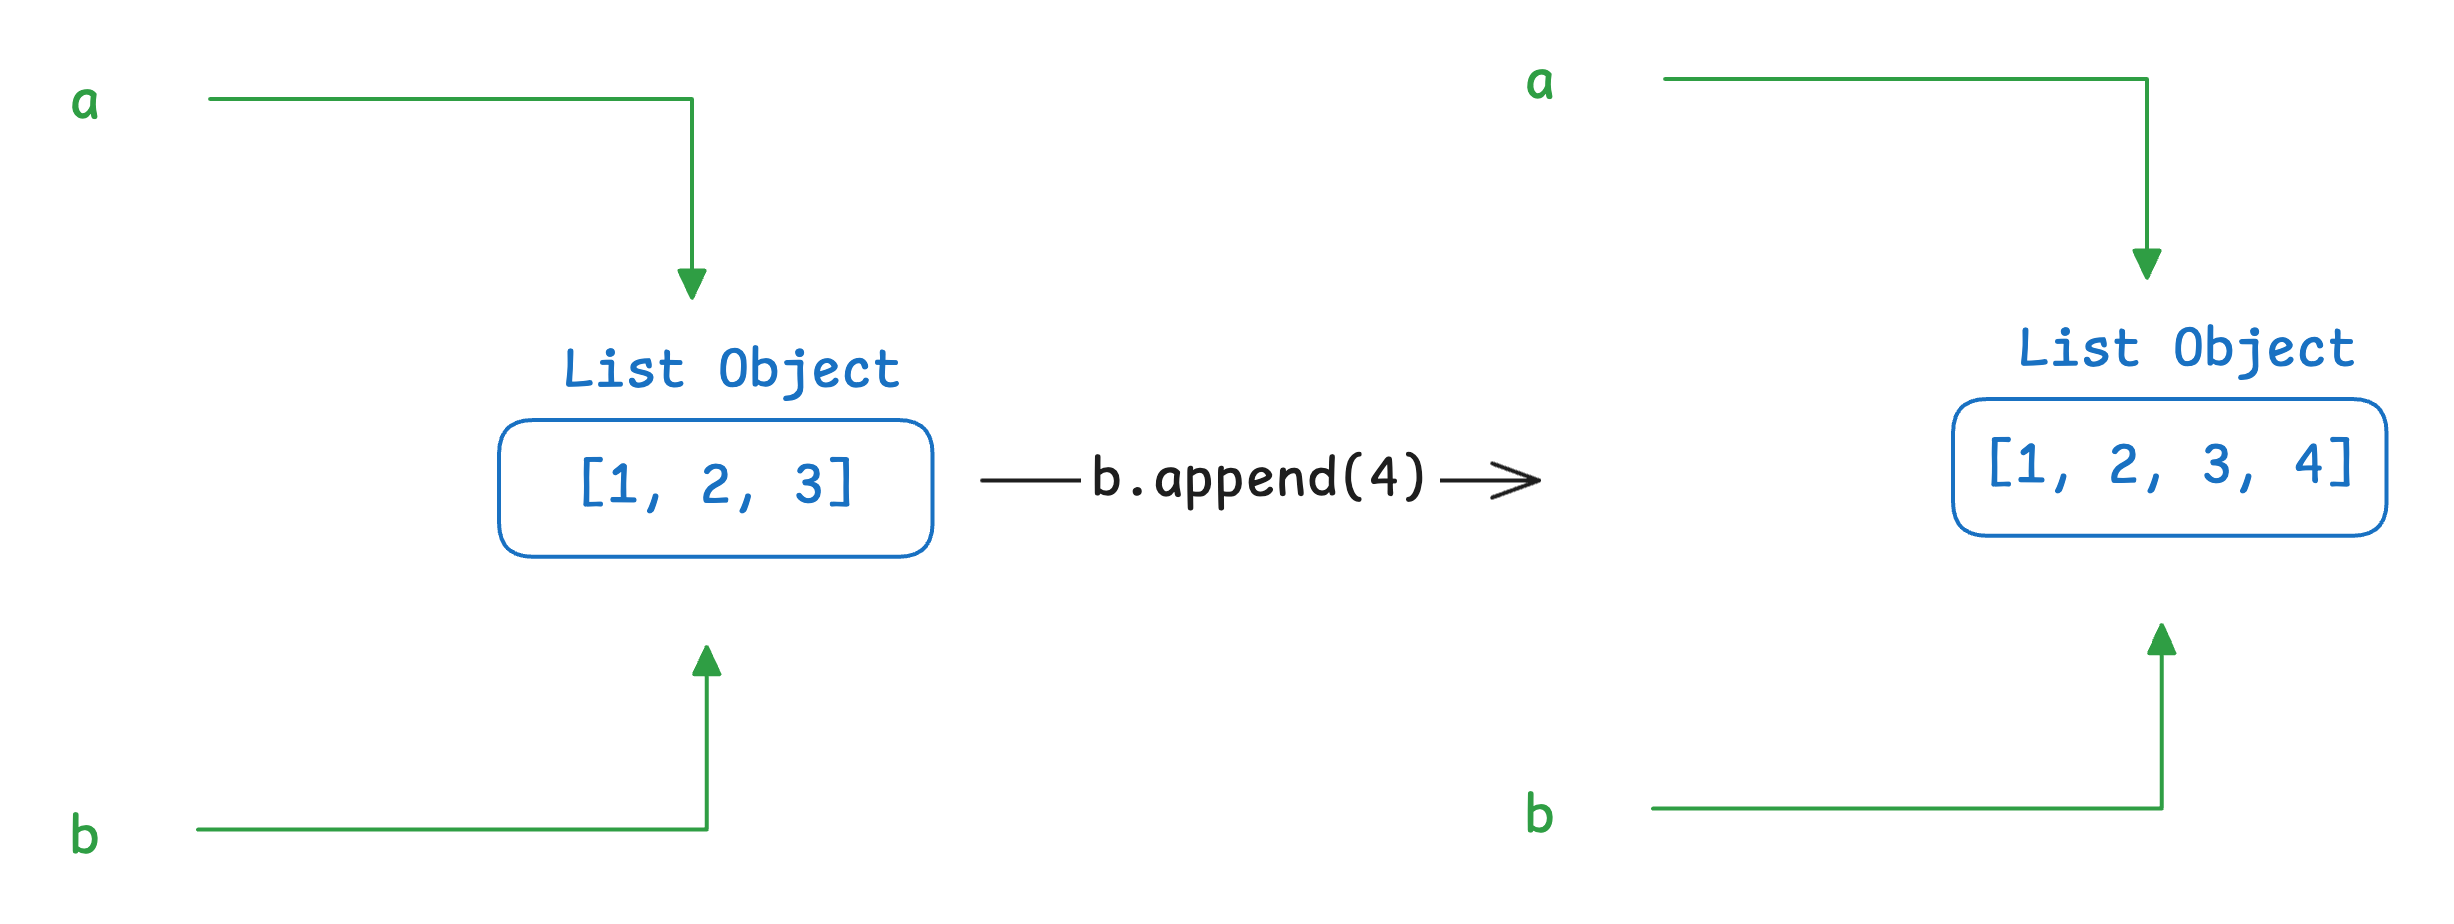
append()는 b의 Binding을 변경하는 것이 아니라 리스트 객체 자체를 변경합니다.
print(a)
# [1, 2, 3, 4]
마치며
Python에서 변수는 값을 직접 저장하는 공간이라기보다, 객체에 바인딩된 이름으로 이해하는 것이 좋습니다.
이러한 바인딩은 Namespace에서 관리되며 Scope는 현재 코드에서 어떤 이름에 접근할 수 있는지를 결정합니다. 또한 객체의 값이 변경 가능한지에 따라 Mutable과 Immutable로 구분됩니다.
다음 글에서는 Execution Model을 중심으로 Python 코드가 Bytecode로 변환되고, Frame과 Bytecode Interpreter를 통해 실행되는 과정을 살펴보겠습니다.
참고 문서
- Python 3.14 — Data Model
- Python 3.14 — Execution Model
- Python 3.14 — Built-in Functions
- Python 3.14 — builtins
'Lang > Python' 카테고리의 다른 글
| [Python] (4) Data Model (0) | 2026.09.26 |
|---|---|
| [Python] (3) Execution Model (0) | 2026.09.22 |
| [Python] (1) GIL (0) | 2026.09.21 |
| Python (4) - 내장 함수, 표준 라이브러리, 외부 라이브러리 (2) | 2025.05.18 |
| Python (3) - 클래스, 모듈, 패키지, 예외 처리 (0) | 2025.05.13 |