Memory Management
앞선 글에서는 Python 코드가 Code Object와 Bytecode로 변환되고, Execution Frame과 Bytecode Interpreter를 통해 실행되는 과정을 살펴보았습니다.
그 과정에서 Python은 계속해서 새로운 객체를 생성하고 사용합니다.
a = 10
users = []
name = "Python"
위 코드의 10, [], "Python"은 모두 Python 객체입니다.
그렇다면 이러한 객체를 저장할 메모리는 어디에서 가져오고 더 이상 사용하지 않는 객체의 메모리는 언제 회수될까요?
Python의 Memory Management는 크게 두 가지 관점으로 나누어볼 수 있습니다.
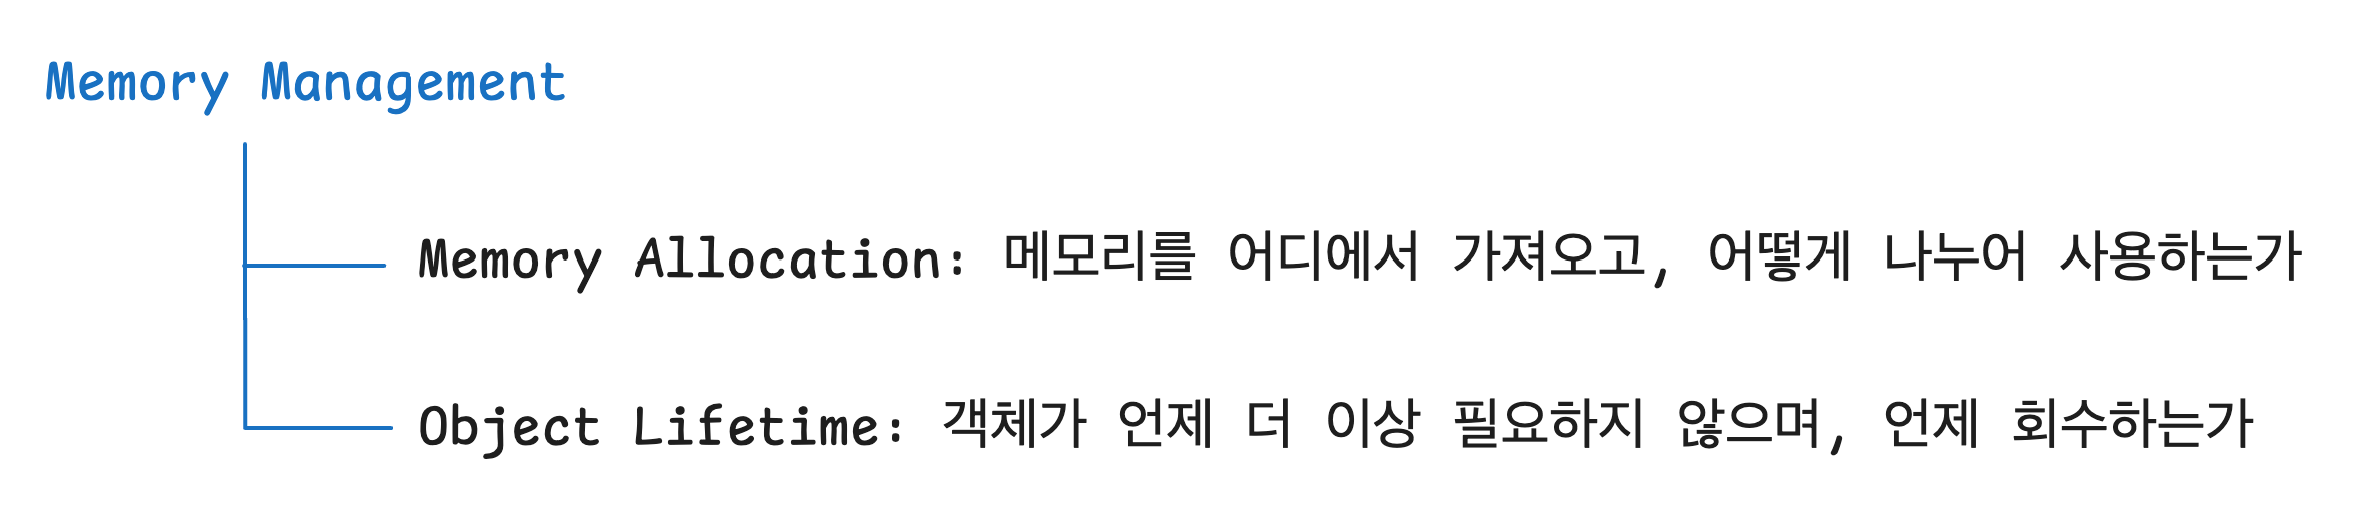
CPython에서는 Python Memory Manager와 전용 Memory Allocator를 통해 객체에 필요한 메모리를 관리하고 Reference Counting을 기본적인 객체 수명 관리 방식으로 사용합니다. 또한 Reference Counting만으로 처리하기 어려운 순환 참조를 보완하기 위해 Garbage Collector가 함께 동작합니다.
Private Heap
Python 공식 Memory Management 문서는 Python 객체와 자료구조가 Private Heap에 존재하며 이 영역은 Python Memory Manager가 내부적으로 관리한다고 설명합니다.
여기서 Private Heap이라는 표현은 CPython 프로세스의 전체 메모리 구조가 Private Heap 하나로만 구성된다는 의미는 아닙니다.
CPython 역시 운영체제에서 실행되는 하나의 프로세스이므로 일반적인 프로세스와 마찬가지로 Native Stack, Code 영역, Shared Library 등 여러 메모리 영역을 사용합니다.
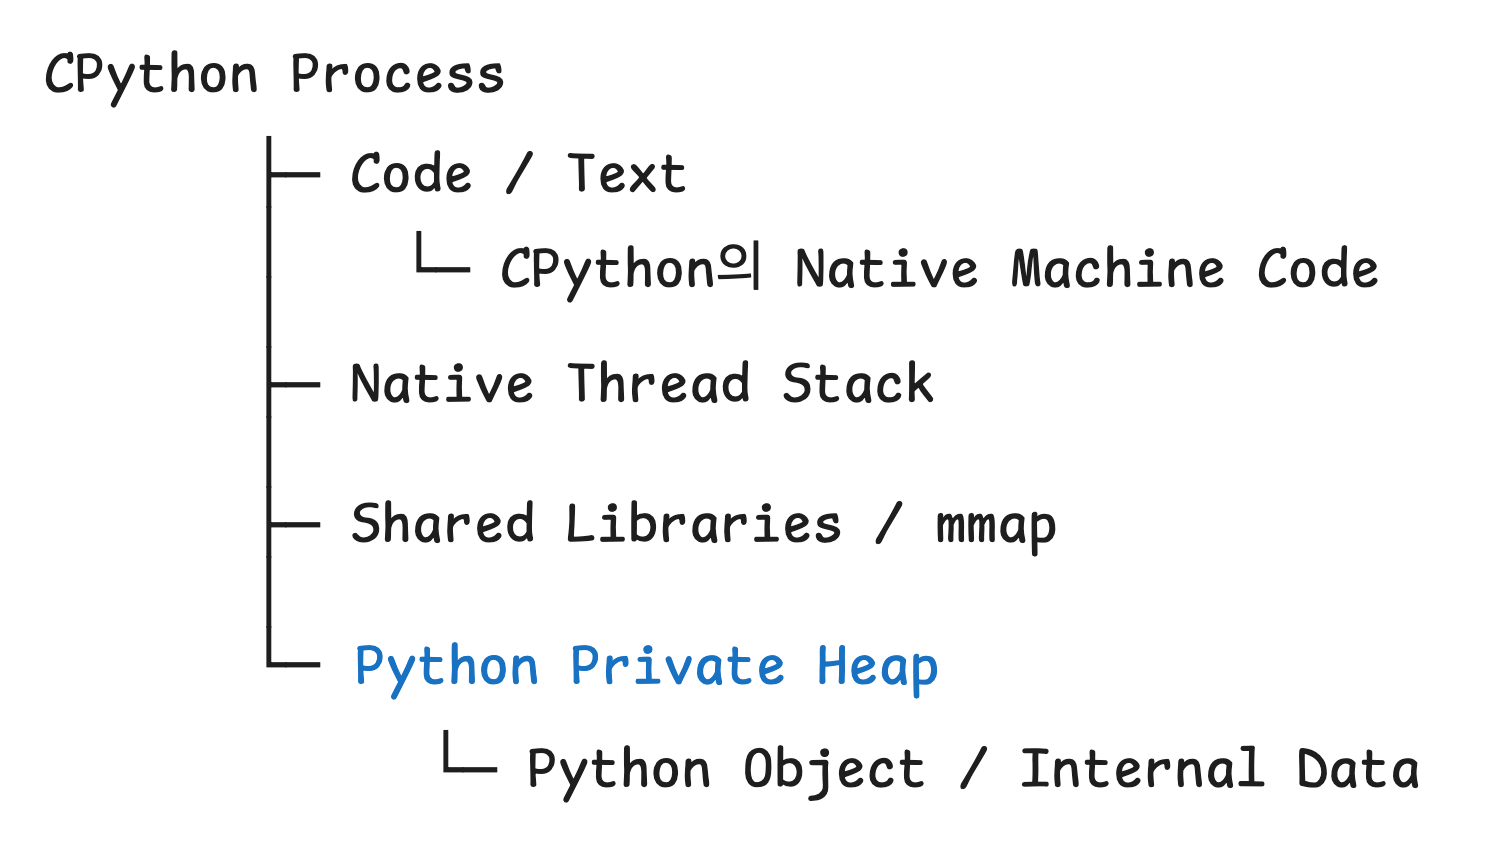
Private Heap은 이 중 Python 객체와 Python Runtime 내부 데이터의 동적 메모리를 관리하기 위한 영역으로 이해하는 것이 좋습니다.
Python 개발자가 일반적인 코드에서 이 영역의 메모리를 직접 할당하거나 해제하지는 않고 Python Runtime이 필요한 크기의 메모리를 판단하고 Python Memory Manager를 통해 할당합니다.
공식 문서에서도 Python Heap의 관리는 Interpreter 자체에서 수행되며 Python 객체와 내부 Buffer를 위한 Heap 공간은 Python/C API를 통해 필요한 시점에 할당된다고 설명합니다.
따라서 전체적인 관계를 단순화하면 다음과 같습니다.
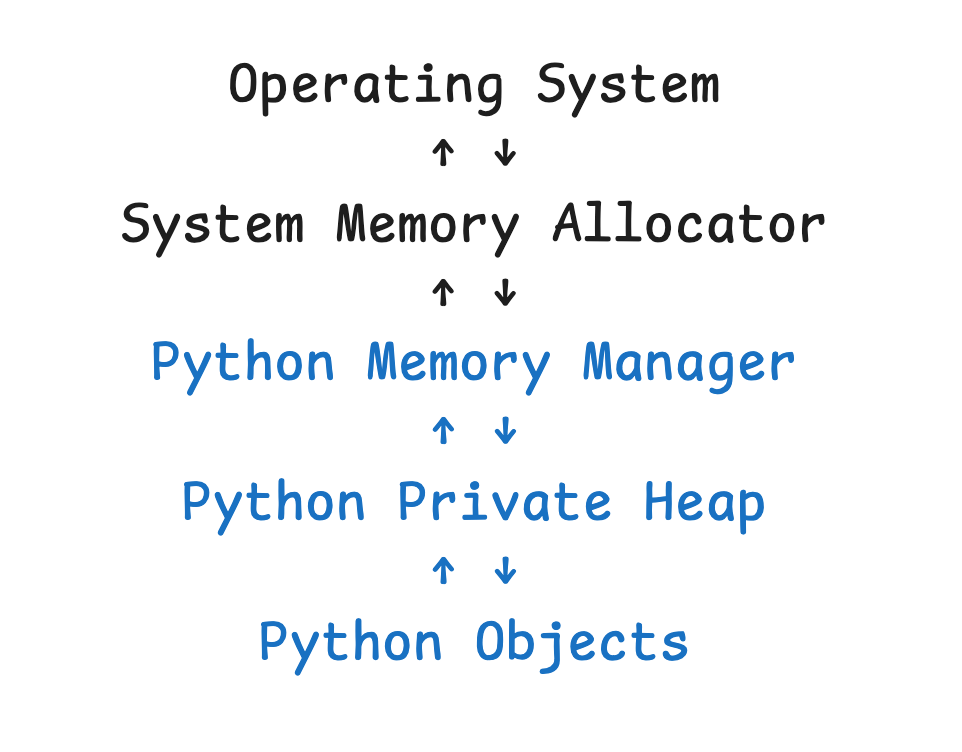
여기서 중요한 점은 Python Memory Manager가 운영체제의 Memory Manager를 대체하는 것이 아니라는 것입니다.
CPython 역시 최종적으로는 운영체제에서 메모리를 받아와야 하며 Python Memory Manager는 그 위에서 Python 객체의 특성에 맞게 메모리를 보다 효율적으로 관리하는 계층입니다.
Allocator Domain
CPython의 Memory Allocation API는 용도에 따라 세 가지 Allocator Domain으로 구분됩니다.
- Raw Domain
- Mem Domain
- Object Domain
공식 문서는 각 Domain이 서로 다른 목적과 Allocation Strategy를 가진다고 설명합니다.
Raw Domain
Raw Domain은 시스템 수준의 일반적인 메모리 할당에 사용됩니다.
대표적인 API는 다음과 같습니다.
PyMem_RawMalloc()
PyMem_RawCalloc()
PyMem_RawRealloc()
PyMem_RawFree()
기본 Raw Allocator는 C 표준 라이브러리의 API를 사용합니다.
malloc()
calloc()
realloc()
free()
즉 Raw Domain은 Python Private Heap의 객체 관리 전략을 거치기보다는 시스템 Allocator에서 직접 메모리를 요청해야 하는 경우에 사용됩니다.
Mem Domain
Mem Domain은 Python 내부에서 사용하는 일반적인 Buffer 등을 할당하기 위한 Domain입니다.
PyMem_Malloc()
PyMem_Calloc()
PyMem_Realloc()
PyMem_Free()
공식 문서에서는 이 Domain의 메모리가 Python Private Heap에서 가져와진다고 설명합니다.
Object Domain
Object Domain은 이름 그대로 Python Object를 위한 메모리를 할당하는 Domain입니다.
PyObject_Malloc()
PyObject_Calloc()
PyObject_Realloc()
PyObject_Free()
예를 들어 새로운 Python 객체를 생성하기 위해 필요한 메모리를 확보할 때 이 Domain이 사용될 수 있습니다.
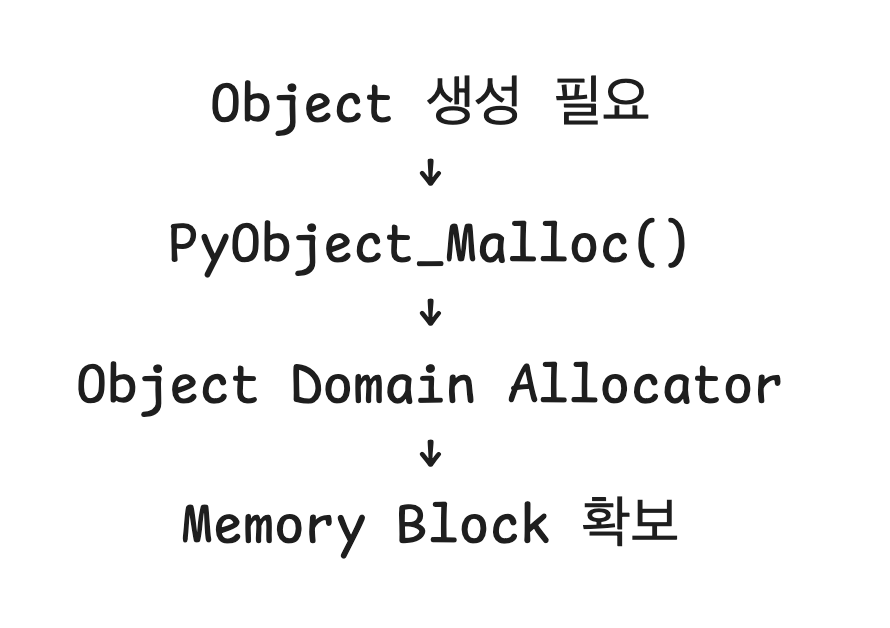
Object Domain의 메모리 역시 Python Private Heap에서 관리됩니다.
이 세 Domain을 정리하면 다음과 같습니다.
Python Memory Allocator
- Raw Domain
- 일반적인 Low-level Memory
- System Allocator 사용
- Mem Domain
- Python 내부 Buffer 등
- Python Private Heap
- Object Domain
- Python Object
- Python Private Heap
여기서 Domain은 서로 완전히 별개의 물리적인 Heap을 의미하는 것이 아니라 메모리 할당의 목적과 API를 구분하기 위한 논리적인 영역에 가깝습니다.
또한 메모리를 할당한 Domain과 해제하는 Domain을 일치시켜야 합니다.
공식 문서도 서로 다른 Allocator Domain의 할당 함수와 해제 함수를 혼용해서는 안 된다고 명시하고 있습니다.
Pymelloc
Python 프로그램은 작은 객체를 매우 자주 생성하고 제거합니다.
예를 들어 다음과 같은 코드가 있다고 하겠습니다.
for i in range(1_000_000):
    obj = SomeObject()
객체 하나를 생성할 때마다 운영체제의 malloc()이나 mmap()을 직접 호출한다면 작은 메모리 요청이 매우 자주 발생하게 됩니다.
이러한 비용을 줄이기 위해 기본 GIL-enabled CPython은 pymalloc이라는 전용 Memory Allocator를 사용합니다.
pymalloc은 하나의 함수가 아니라 CPython이 작은 메모리 요청을 효율적으로 처리하기 위해 구현한 Memory Allocator입니다.
Python 3.14 공식 문서에서는 pymalloc을 512 Byte 이하의 작고 수명이 짧은 Allocation에 최적화된 Allocator라고 설명합니다.
기본 CPython Release Build에서는 다음과 같이 사용됩니다.
- Raw Domain
- system malloc
- Mem Domain
- pymalloc
- Object Domain
- pymalloc
앞서 보았던 Object Domain Allocator로 pymalloc가 사용됩니다.
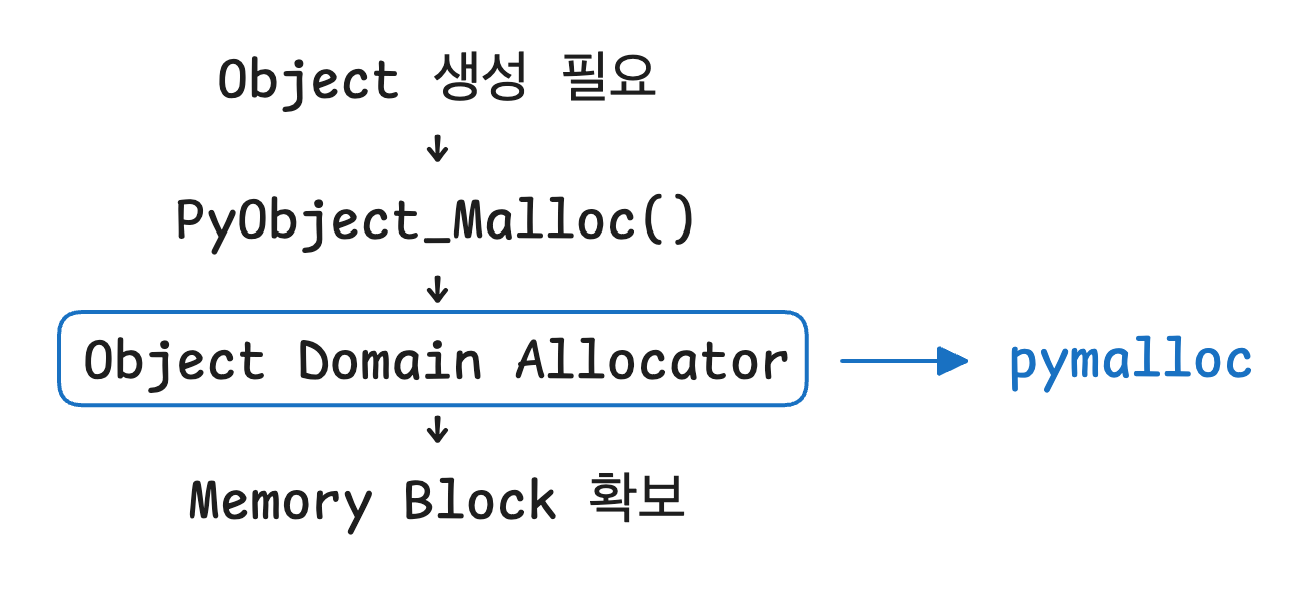
Arena
pymalloc은 운영체제에 객체 하나의 크기만큼 계속 요청하는 대신 비교적 큰 메모리 영역을 확보한 뒤 이를 작은 Allocation에 재사용하는데, 이 큰 단위를 Arena라고 합니다.
Python 3.14 기준 pymalloc Arena의 기본 크기는 다음과 같습니다.
- 32-bit Platform → 256 KiB
- 64-bit Platform → 1 MiB
512 Byte를 초과하는 Allocation은 pymalloc의 작은 객체 관리 경로 대신 PyMem_RawMalloc() 등의 Lower-level Allocator로 넘어갑니다.
64-bit 환경을 기준으로 단순화하면 pymalloc는 OS로부터 Arena를 확보하고, 이 Arena를 다시 작은 단위로 나누어 관리합니다.
CPython의 실제 pymalloc 구현에서는 Arena를 여러 Pool로 나누어 관리하며 각 Pool에서 실제 Allocation에 사용할 Block을 관리하는 구조를 사용합니다. 이는 Python 언어 규격이 아니라 CPython 내부 구현 세부사항입니다.
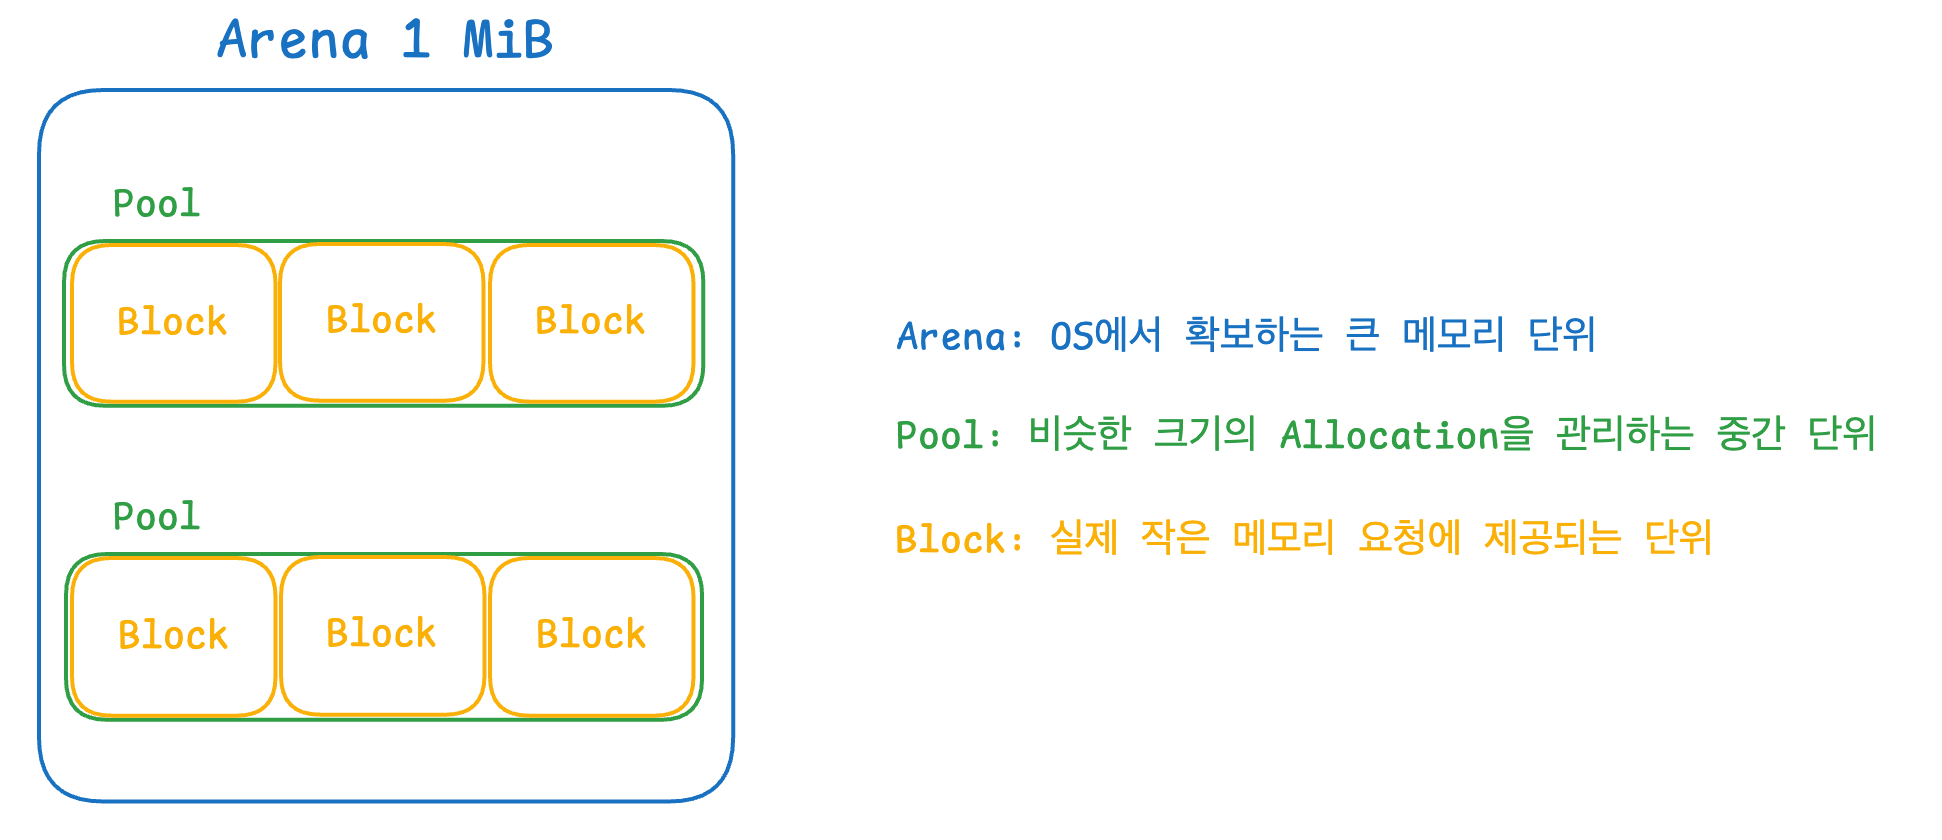
이러한 구조를 사용하는 중요한 이유는 재사용입니다.
객체 하나가 사라졌다고 매번 운영체제에 메모리를 반납하는 것이 아니라 비어 있는 Block을 보관했다가 이후 새로운 객체가 필요할 때 다시 사용할 수 있습니다.
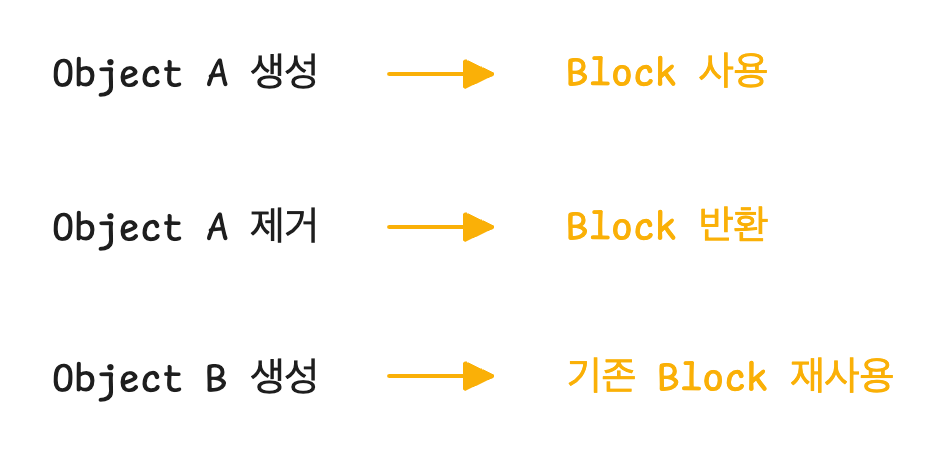
이렇게 하면 작은 객체를 반복적으로 생성하고 제거할 때 System Allocator를 매번 호출하는 비용을 줄일 수 있습니다.
Reference Counting
지금까지는 "객체를 만들기 위한 메모리를 어떻게 할당하는가" 를 살펴보았습니다.
이제 반대 방향의 문제가 남습니다.
"만들어진 객체는 언제 더 이상 필요하지 않다고 판단할 것인가?"
CPython에서는 Reference Counting이 기본적인 객체 수명 관리 방식입니다.
Python 객체는 자신을 가리키는 Strong Reference의 수를 관리하며 C API에서는 Py_INCREF()와 Py_DECREF() 등의 연산을 통해 Reference Count를 관리합니다.
예를 들어 리스트를 생각해보겠습니다.
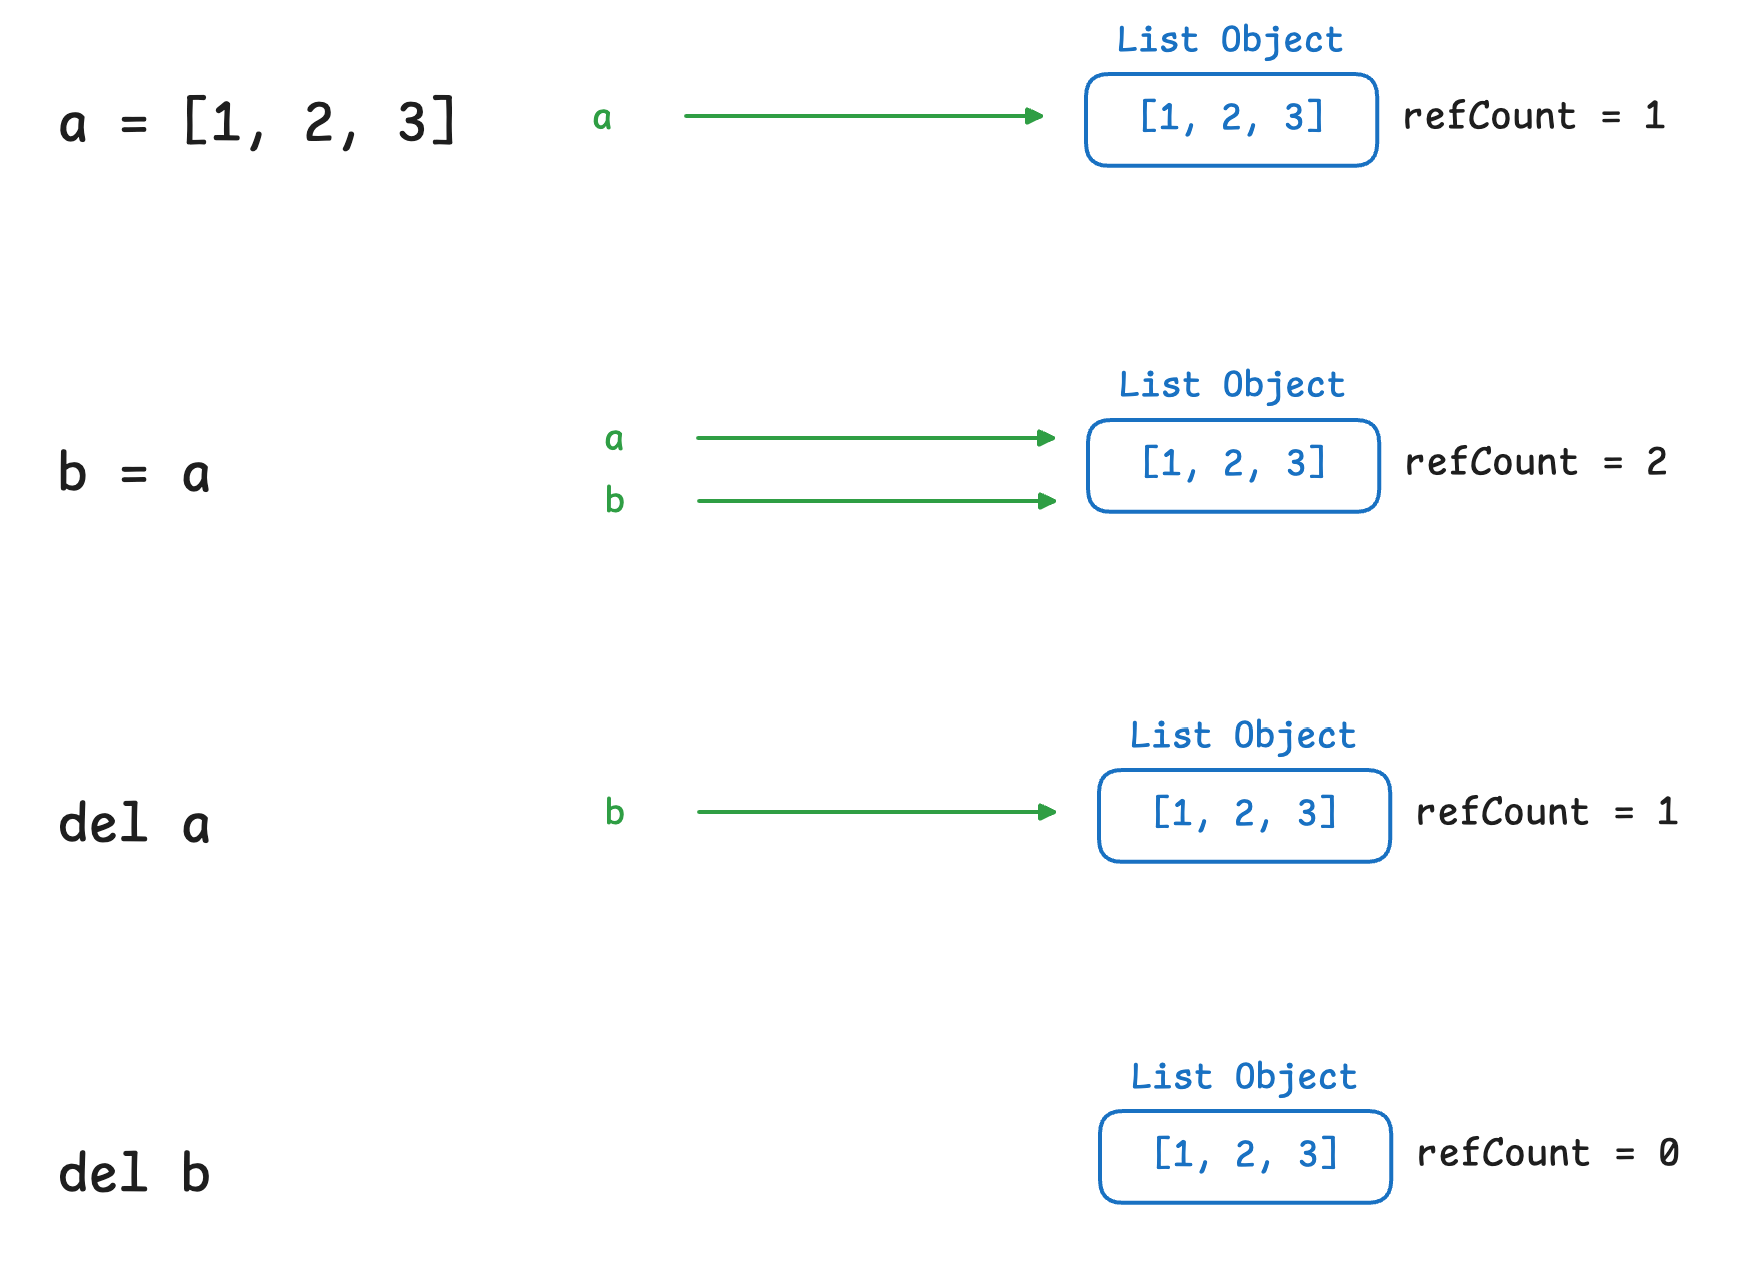
마지막으로 del b 까지 실행하여 마지막 Strong Reference가 사라지면 일반적인 객체에서는 Reference Count가 0이 됩니다.
공식 C API 문서에 따르면 마지막 Strong Reference가 해제되어 Reference Count가 0이 되면 해당 객체 Type의 Deallocation Function이 호출되고 Deallocator에 의해서 Object Memory가 해제됩니다.
이 때문에 CPython에서는 많은 객체가 더 이상 사용되지 않는 시점에 비교적 즉각적으로 정리될 수 있습니다.
Py_INCREF / Py_DECREF
CPython의 C API에서는 새로운 Strong Reference를 소유하게 되었을 때
# Strong Reference 증가
Py_INCREF(obj);
를 사용할 수 있습니다.
반대로 해당 Reference가 더 이상 필요하지 않으면
# Strong Reference 감소
Py_DECREF(obj);
를 사용합니다.
Py_DECREF()에 의해 마지막 Strong Reference가 해제되면 객체의 Deallocator가 실행될 수 있습니다.
다만 최근 CPython에는 Immortal Object와 Free-threaded Build 등 Reference Count를 보다 복잡하게 만드는 구현도 존재합니다. 공식 Python 3.14 문서 역시 일부 Immortal Object에서는 실제 Reference의 수와 Py_REFCNT() 값이 일치하지 않을 수 있다고 명시하고 있습니다.
Cyclic GC
Reference Counting만으로 대부분의 객체 수명을 관리할 수 있지만 해결하기 어려운 대표적인 경우가 있습니다.
바로 Circular Reference, 즉 순환 참조입니다.
예를 들어 다음 코드를 실행하면 두 리스트가 서로를 참조합니다.
a = []
b = []

a.append(b)
b.append(a)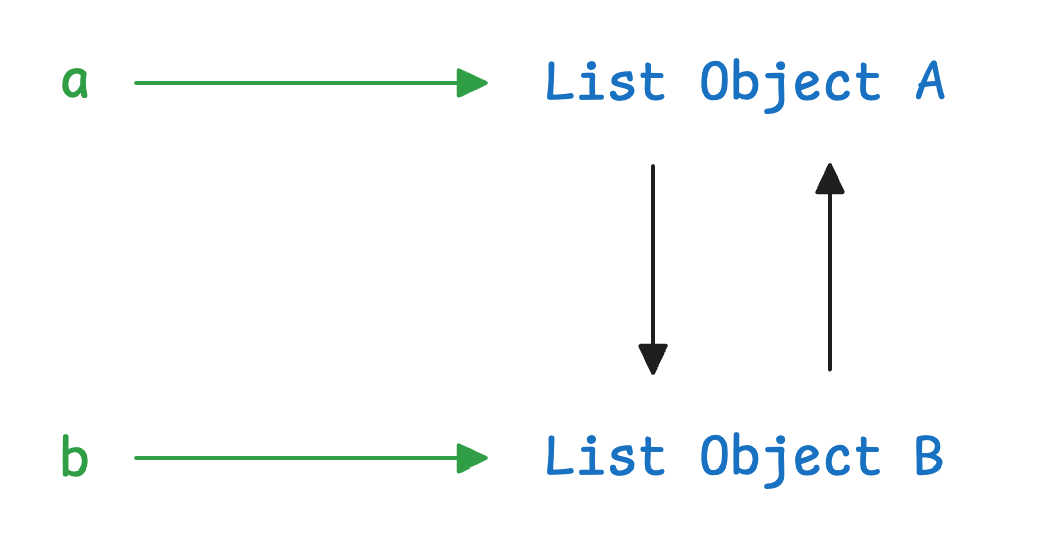
이후 외부의 이름을 제거하면 프로그램에서는 더 이상 두 객체에 접근할 방법이 없지만 두 객체는 여전히 서로 참조하고 있습니다.
del a
del b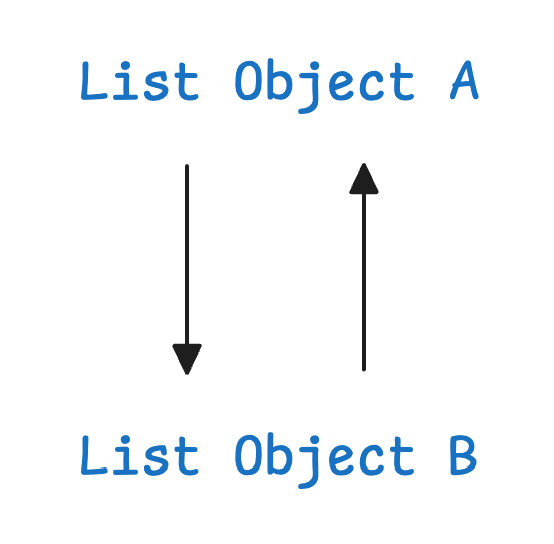
따라서 Reference Counting만 보면 두 객체의 Reference Count가 0이 되지 않을 수 있습니다.
즉 프로그램 관점에서는 Garbage이지만 Reference Counting만으로는 이를 판단하기 어렵습니다.
이를 해결하기 위해 CPython에는 별도의 Cyclic Garbage Collector가 존재합니다.
Python 공식 gc 문서는 Garbage Collector가 Python의 기존 Reference Counting을 보완한다고 명시하고 있습니다.
여기서 중요한 점은 CPython에서 GC가 Reference Counting을 대신하는 것이 아니라, Reference Counting이 처리하지 못하는 순환 참조를 보완한다는 것입니다.
참고로 Java에서는 Reference Counting이 아닌 Reachability 기반의 GC로 객체 수명을 관리합니다.
Generational GC
CPython의 Cyclic GC는 모든 추적 대상 객체를 매번 동일하게 검사하지 않고 객체가 Collection을 얼마나 오래 살아남았는지에 따라 Generation을 사용합니다.
현재 Python 3.14 문서에서는 새로운 객체를 Generation 0에 두고, Collection에서 살아남은 객체를 Generation 1로 이동하고, 또 다시 Collection에서 살아남은 객체를 Generation 2로 이동시킵니다.
이는 일반적으로 "새롭게 만들어진 객체일수록 비교적 빨리 Garbage가 될 가능성이 높다." 는 특성을 활용하기 위한 방식입니다.
Python에서는 gc 모듈을 통해 Garbage Collector의 상태를 확인하거나 직접 Collection을 요청할 수도 있습니다.
import gc

gc.collect()
또한 특정 객체가 GC의 추적 대상인지 확인할 수도 있습니다.
gc.is_tracked([])
# True

gc.is_tracked(0)
# False
공식 문서에 따르면 숫자나 문자열 같은 Atomic Type은 일반적으로 Cyclic GC가 추적하지 않고 다른 객체를 참조할 수 있는 Container나 사용자 정의 객체가 주요 추적 대상입니다.
Memory Release
여기서 흔히 발생하는 오해가 하나 있습니다.
del objects
del를 실행하여 객체가 더 이상 필요하지 않게 되었다고 해서 해당 메모리가 곧바로 운영체제에 반환된다고 볼 수는 없습니다.
객체의 수명 종료와 운영체제로의 메모리 반환은 서로 다른 단계입니다.
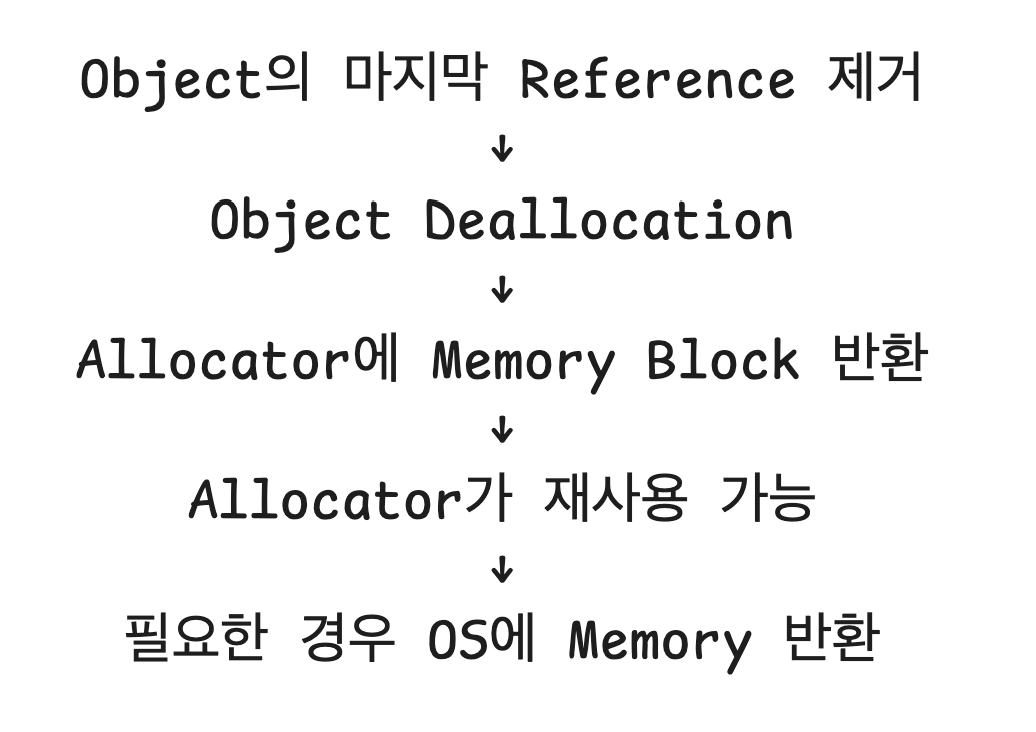
이 때문에 많은 객체를 제거한 직후에도 운영체제에서 보는 RSS(Resident Set Size)가 곧바로 같은 크기만큼 감소하지 않을 수 있습니다.
따라서 Python 서버에서 메모리를 분석할 때는 단순히 "객체를 삭제했는가?" 뿐만 아니라
- Reference가 실제로 남아 있는가?
- 순환 참조가 있는가?
- Allocator 내부에 재사용 가능한 메모리가 남아 있는가?
- 프로세스 RSS는 어떻게 변화하는가?
를 서로 구분해서 볼 필요가 있습니다.
Python에는 이러한 Memory Allocation을 추적하기 위한 tracemalloc 표준 모듈도 제공됩니다.
import tracemalloc

tracemalloc.start()

# Application Code

snapshot = tracemalloc.take_snapshot()
tracemalloc은 Python이 할당한 Memory Block의 위치, 크기와 개수 등을 추적할 수 있으며 두 Snapshot을 비교해 Allocation 증가 지점을 찾는 기능도 제공합니다.
Free-threaded
앞선 GIL 글에서 살펴본 Free-threaded CPython에서는 Memory Allocation 방식에도 차이가 있습니다.
기본적인 GIL-enabled CPython의 Release Build에서는 Mem Domain과 Object Domain의 기본 Allocator로 pymalloc을 사용합니다.
반면 Python 3.13부터 도입된 Free-threaded Build에서는 기본 Allocator로 mimalloc을 사용합니다. Python 3.14 공식 문서에서는 Free-threaded Build에서 Mem Domain과 Object Domain에 mimalloc을 사용하며 해당 구성에서는 mimalloc이 필수 Allocator라고 설명합니다.
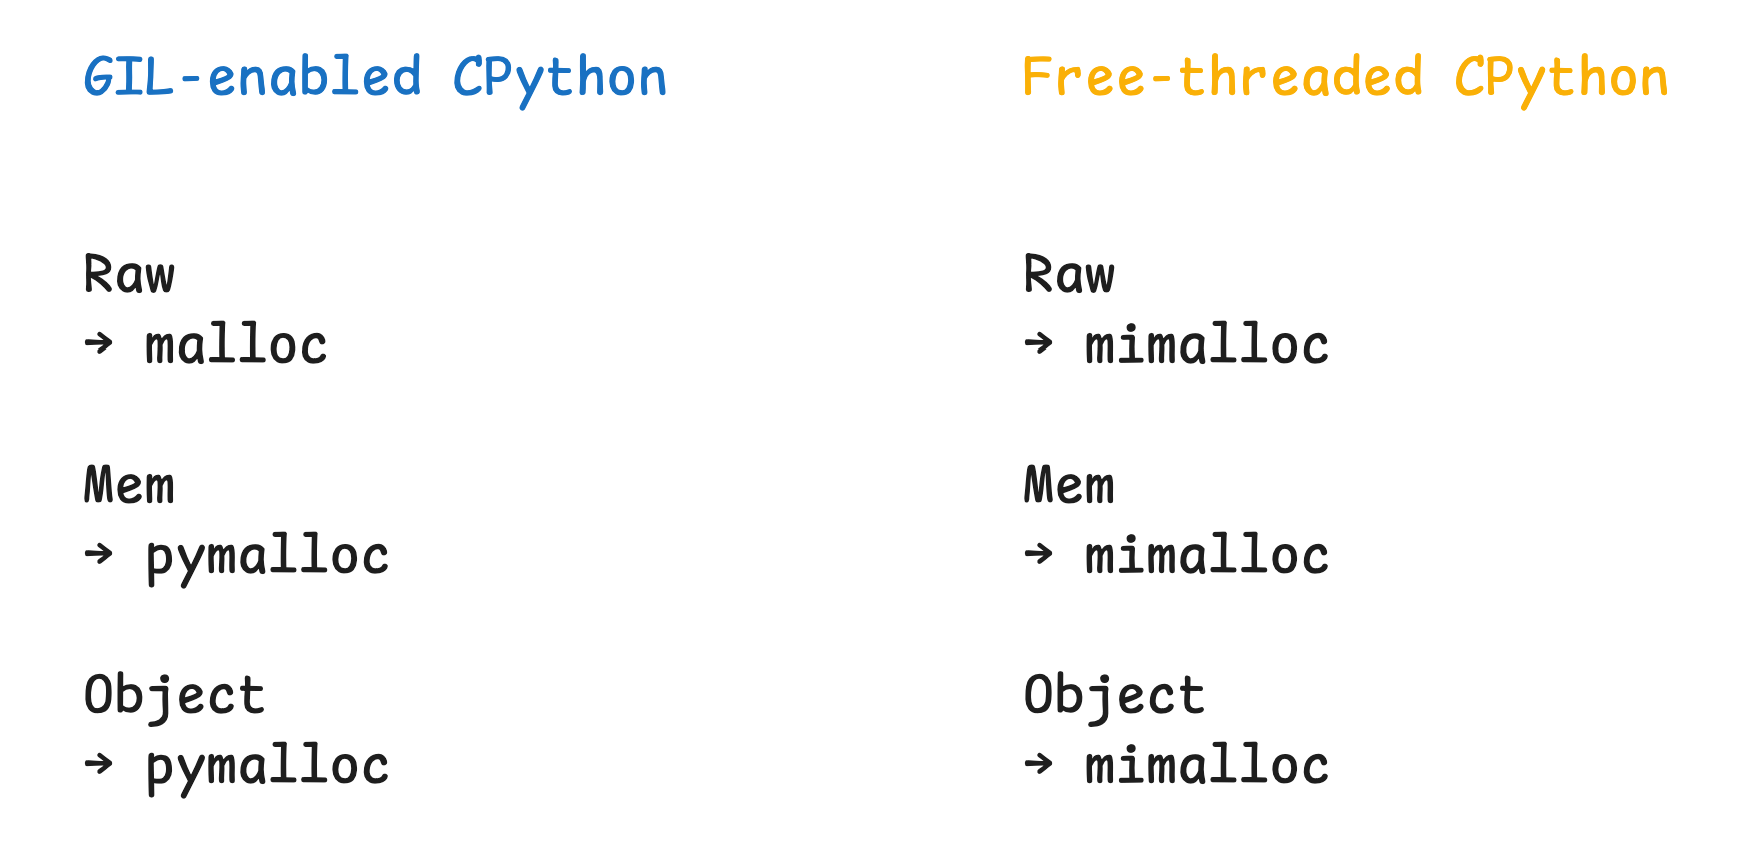
mimalloc은 pymalloc과 달리 512 Byte 이하의 작은 Allocation에만 특화된 Allocator가 아니라 다양한 크기의 Allocation을 처리하는 General-purpose Allocator입니다. Free-threaded Build에서는 Thread별 Heap을 사용하여 대부분의 Allocation과 Deallocation을 Lock 없이 처리할 수 있도록 구성되어 있습니다.
다만 이는 Python 객체 공간 자체가 Thread별로 격리된다는 의미는 아니며 Allocator 내부의 메모리 관리 구조가 Thread별로 분리된다는 것입니다.
Reference Counting과 Garbage Collection이라는 큰 객체 수명 관리 구조는 계속 존재하지만, Free-threaded 환경에서는 Reference Count와 Memory Reclamation의 내부 구현이 동시성을 고려하여 더욱 복잡해집니다.
마치며
CPython의 Memory Management는 크게 Allocation과 Object Lifetime으로 나누어 볼 수 있습니다.
기본 GIL-enabled CPython에서는 작은 Allocation을 효율적으로 처리하기 위해 pymalloc을 사용하고 객체의 수명은 주로 Reference Counting으로 관리합니다. 그리고 Cyclic GC는 Reference Counting만으로 해결하기 어려운 순환 참조를 보완합니다.
다음 글에서는 한 단계 더 내려가 Object Internals를 중심으로 PyObject, PyLongObject, PyListObject 등의 실제 CPython 구조를 살펴보겠습니다.
참고 문서
'Lang > Python' 카테고리의 다른 글
| [Python] (6) Object Internals (0) | 2026.09.26 |
|---|---|
| [Python] (4) Data Model (0) | 2026.09.26 |
| [Python] (3) Execution Model (0) | 2026.09.22 |
| [Python] (2) Object Model (0) | 2026.09.21 |
| [Python] (1) GIL (0) | 2026.09.21 |