Object Internals
앞선 글에서는 Python의 모든 값이 객체로 표현된다는 Object Model과 이러한 객체를 위한 메모리를 CPython이 어떻게 할당하고 회수하는지 살펴보았습니다.
이번에는 두 내용을 연결해 실제 Python 객체가 CPython 내부의 메모리에서 어떤 모습으로 존재하는지 살펴보겠습니다.
a = 10
b = [1, 2, 3]
c = {"name": "Python"}
Python 언어 수준에서는 10, [1, 2, 3], {"name": "Python"} 모두 객체입니다.
하지만 실제 CPython 내부에서는 각각 다른 C 구조를 사용합니다.
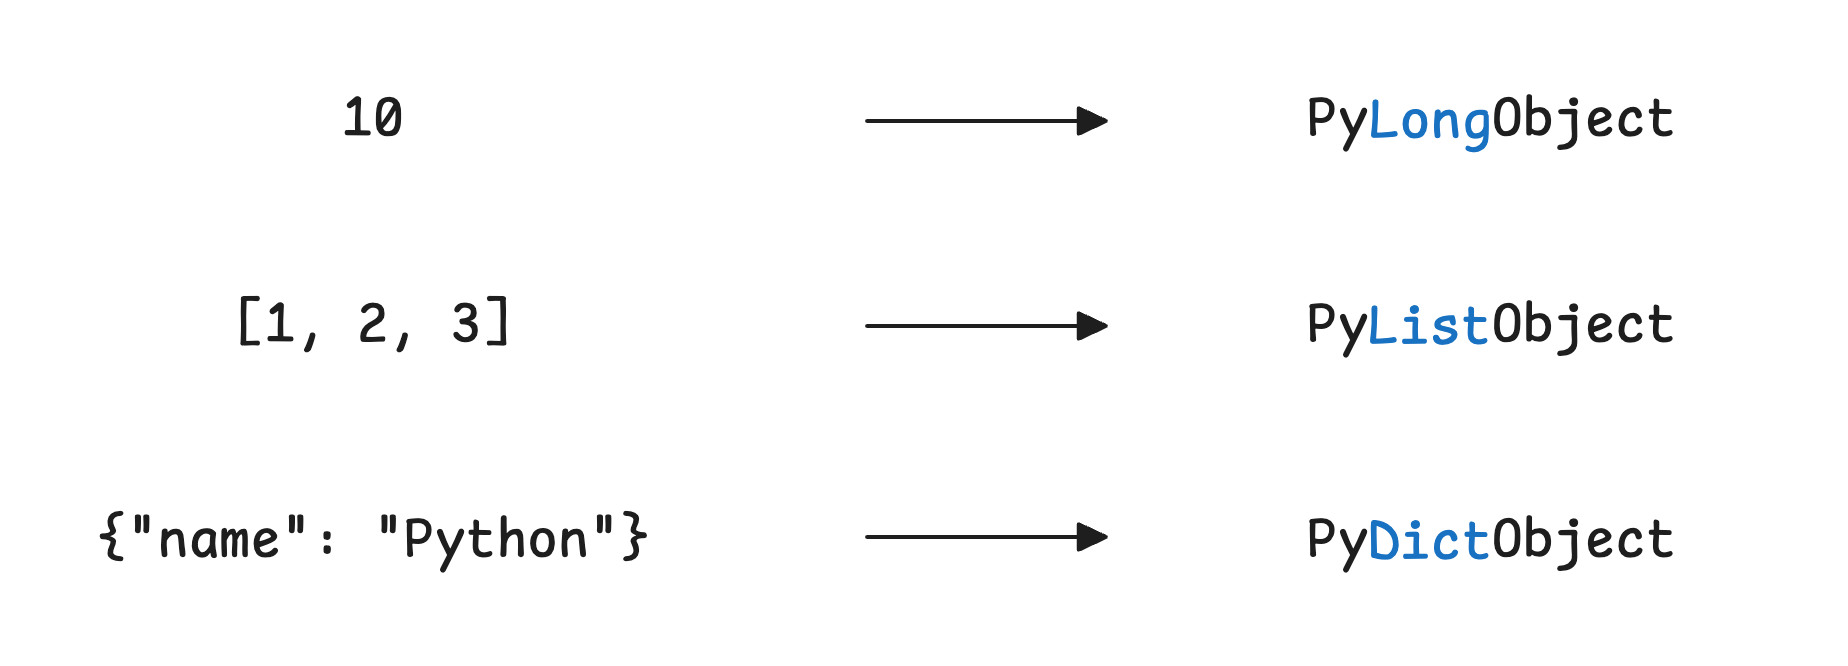
이들 객체는 서로 다른 데이터를 저장하지만 CPython이 모든 객체를 동일한 방식으로 다룰 수 있도록 공통적인 구조 역시 가지고 있습니다.
이번 글에서는 먼저 객체의 공통적인 메모리 구조와 Type 정보를 살펴본 뒤, 객체가 실제로 생성되어 메모리에 올라가는 과정과 각 자료형의 내부 구조를 살펴보겠습니다.
이하 내용은 Python 언어 자체의 규격이 아니라 CPython 3.14 계열의 구현을 기준으로 하며 내부 구조는 Python 버전과 Build 설정에 따라 변경될 수 있습니다.
Object Layout
Python에서 객체는 추상적인 개념으로만 존재하는 것이 아닙니다.
CPython에서는 실제로 메모리에 할당된 C 구조를 통해 Python 객체를 표현합니다.
공식 CPython 소스에서는 모든 Python 객체가 Heap에 할당되며 어떤 객체든 PyObject *를 통해 공통적으로 접근할 수 있도록 설계되어 있다고 설명합니다.
그 기반이 되는 구조가 PyObject입니다.
일반적인 GIL-enabled CPython의 개념을 단순화하면 다음과 같습니다.
typedef struct _object {
    Py_ssize_t ob_refcnt;
    PyTypeObject *ob_type;
} PyObject;
실제 CPython 3.14의 구조는 Build 설정에 따라 Reference Count 관련 필드가 더 복잡할 수 있지만 객체를 이해하기 위해 중요한 정보는 크게 두 가지입니다.
- ob_refcnt: Reference Count
- ob_type: 객체의 Type Object를 가리키는 Pointer
즉 Python 객체의 메모리에는 객체의 실제 값만 들어 있는 것이 아니고 CPython Runtime이 해당 객체를 관리하기 위한 Header가 함께 존재합니다.
PyObject_HEAD
실제 자료형의 구조를 보면 다음과 같은 표현을 자주 볼 수 있습니다.
PyObject_HEAD이는 객체에 PyObject Header를 포함시키기 위한 Macro입니다.
예를 들어 어떤 객체가 다음과 같이 정의되어 있다면:
typedef struct {
    PyObject_HEAD    // ob_refcnt, ob_type
    int value;
} MyObject;
여기서 PyObject와 MyObject Data(value)가 각각 따로 Heap에 할당되는 것이 아니라, 같은 구조체이기 때문에 같은 메모리 할당 안에 연속적으로 배치됩니다.
즉 PyObject는 Python 객체의 실제 값을 표현하는 구조라기보다 모든 Python 객체가 공통적으로 가지는 Runtime Header라고 이해하는 것이 좋습니다.
이 덕분에 CPython은 아래와 같이 실제 구조가 서로 다른 객체라도 공통적으로 PyObject * 로 취급할 수 있습니다.
PyLongObject *
PyListObject *
PyDictObject *
Python 수준에서는 다음과 같이 표현했습니다.
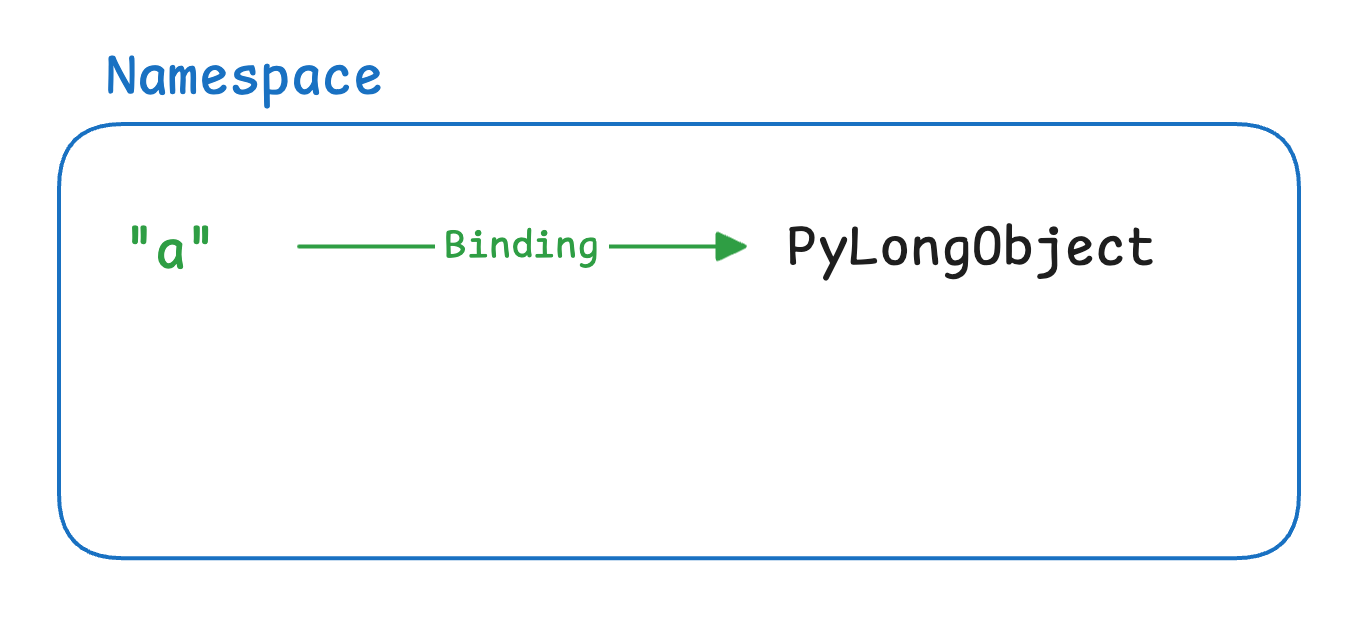
CPython 구현에서는 Object를 참조하는 값이 보통 Pointer 형태로 관리됩니다.
예를 들어 Dictionary 기반 Namespace를 단순화하면 다음과 같습니다.
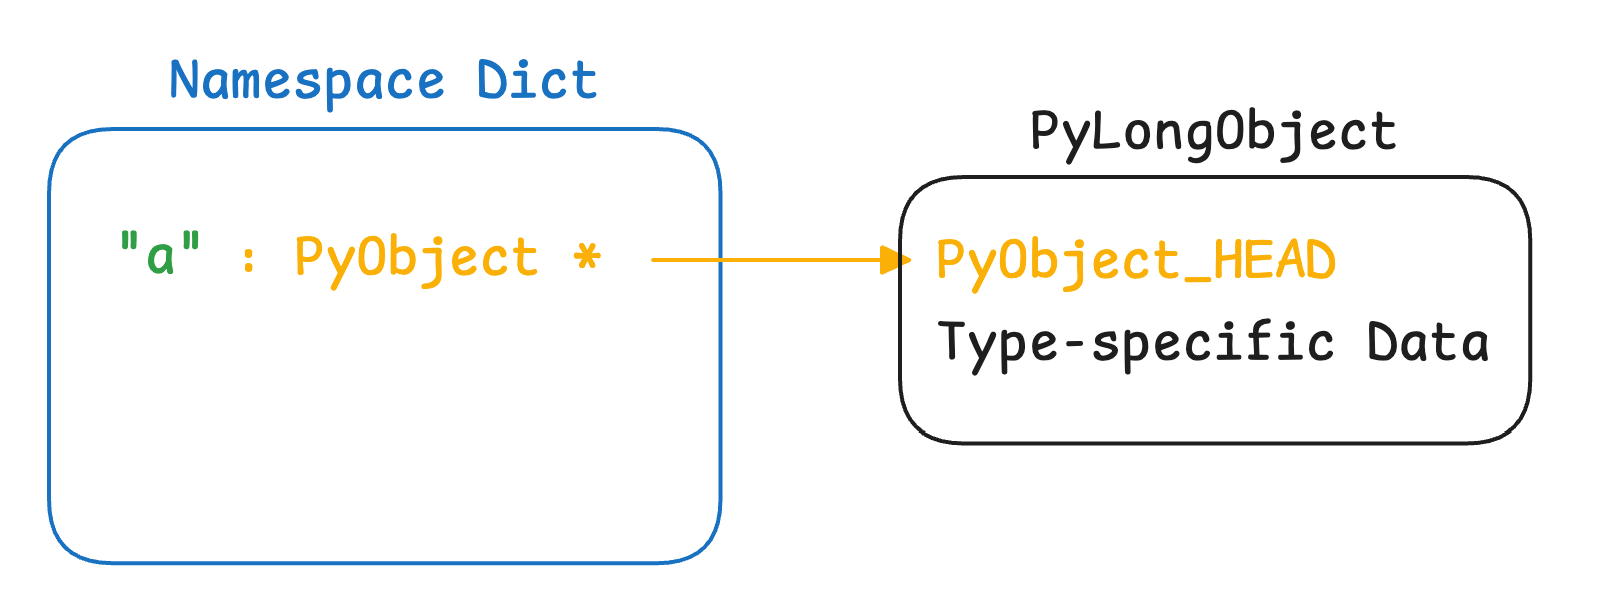
모든 객체는 첫 멤버로 PyObject를 가지므로, 모든 객체의 시작주소는 해당 객체 내부의 PyObject 시작주소와 같기 때문입니다.
PyVarObject
일부 객체는 원소 개수와 같은 크기 정보도 필요합니다.
이를 위해 PyObject를 확장한 PyVarObject가 존재합니다.
struct PyVarObject {
    PyObject ob_base;
    Py_ssize_t ob_size;
};
여기에는 기존 PyObject Header에 원소 수와 같은 논리적인 크기 정보를 저장하는 Py_ssize_t ob_size 가 추가됩니다.
그리고 실제 객체에서는 다음과 같은 Macro를 통해 사용할 수 있습니다.
PyObject_VAR_HEAD
다만 PyVarObject를 사용한다고 해서 객체의 C 구조체 자체가 실행 중 계속 커졌다 작아졌다 한다는 뜻은 아니며 이 부분은 뒤에서 list 구조를 살펴보면서 다시 확인하겠습니다.
Type Object
앞서 살펴본 PyObject에는 다음 필드가 있었습니다.
PyTypeObject *ob_type;
그렇다면 PyTypeObject는 무엇일까요?
Python에서는 아래처럼 모든 객체가 자신의 Type을 가집니다.
a = 10

type(a)
# <class 'int'>
여기에서 int 역시 단순한 문자열이나 Metadata가 아니라 하나의 Python 객체입니다.
CPython에서는 이러한 Type 자체를 PyTypeObject라는 C 구조를 통해 표현합니다.
구조 전체는 상당히 크지만, 이번 글에서 필요한 핵심만 단순화하면 다음과 같습니다.
typedef struct _typeobject {
    PyObject_VAR_HEAD

    const char *tp_name;

    Py_ssize_t tp_basicsize;
    Py_ssize_t tp_itemsize;

    destructor tp_dealloc;

    ...

    hashfunc tp_hash;
    ternaryfunc tp_call;

    ...

    richcmpfunc tp_richcompare;

    ...

    allocfunc tp_alloc;
    newfunc tp_new;
    freefunc tp_free;

    ...

} PyTypeObject;
PyTypeObject에는 단순히 Type의 이름만 저장되는 것이 아닙니다.
해당 Type의 Instance가
- 얼마나 큰 메모리를 필요로 하는지
- 어떻게 생성되는지
- 어떻게 메모리를 할당하는지
- 어떤 연산을 지원하는지
- 어떻게 제거되는지
등을 정의하는 정보와 함수 Pointer가 들어 있습니다.
즉 Type Object는 해당 Type의 Instance를 CPython이 어떻게 생성하고 다뤄야 하는지를 설명하는 Runtime Metadata Object 라고 볼 수 있습니다.
Instance와 Type Object
여기에서 가장 헷갈리기 쉬운 부분이 있습니다.
Python에서 a = 10 이라고 했을 때 10은 하나의 int Instance이며 CPython에서는 이 객체를 PyLongObject로 표현합니다.
반면 int 라는 Type 자체는 PyLongObject가 아닙니다.
CPython에는 다음과 같이 표현합니다.
PyTypeObject PyLong_Type;
따라서 실제 관계는 다음과 같습니다.
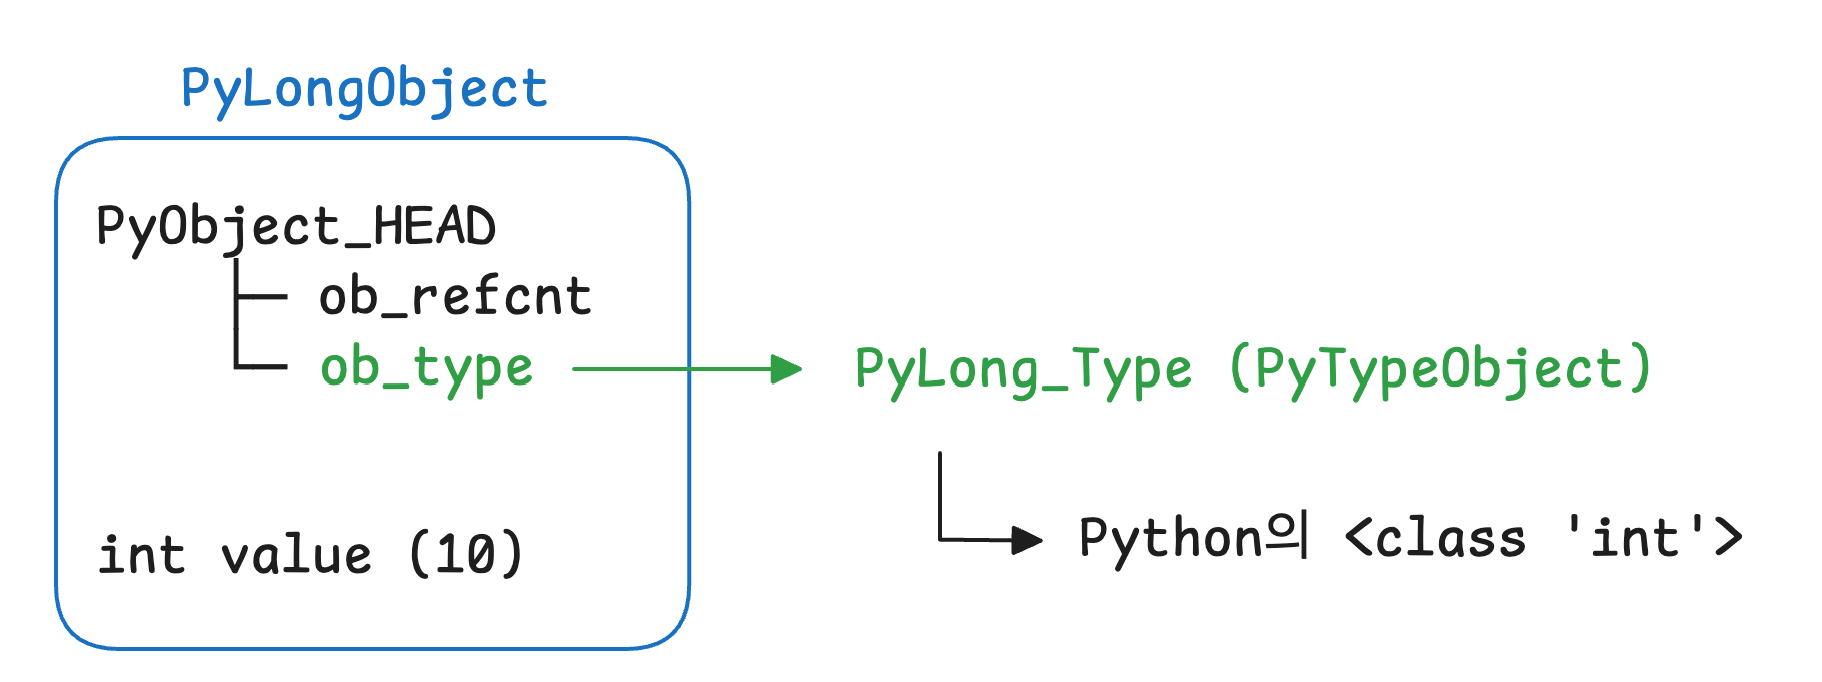
Python 언어 수준에서는 정수 타입을 int로 통일했고, CPython 구현/API의 이름은 PyLong* 계열을 유지하고 있습니다.
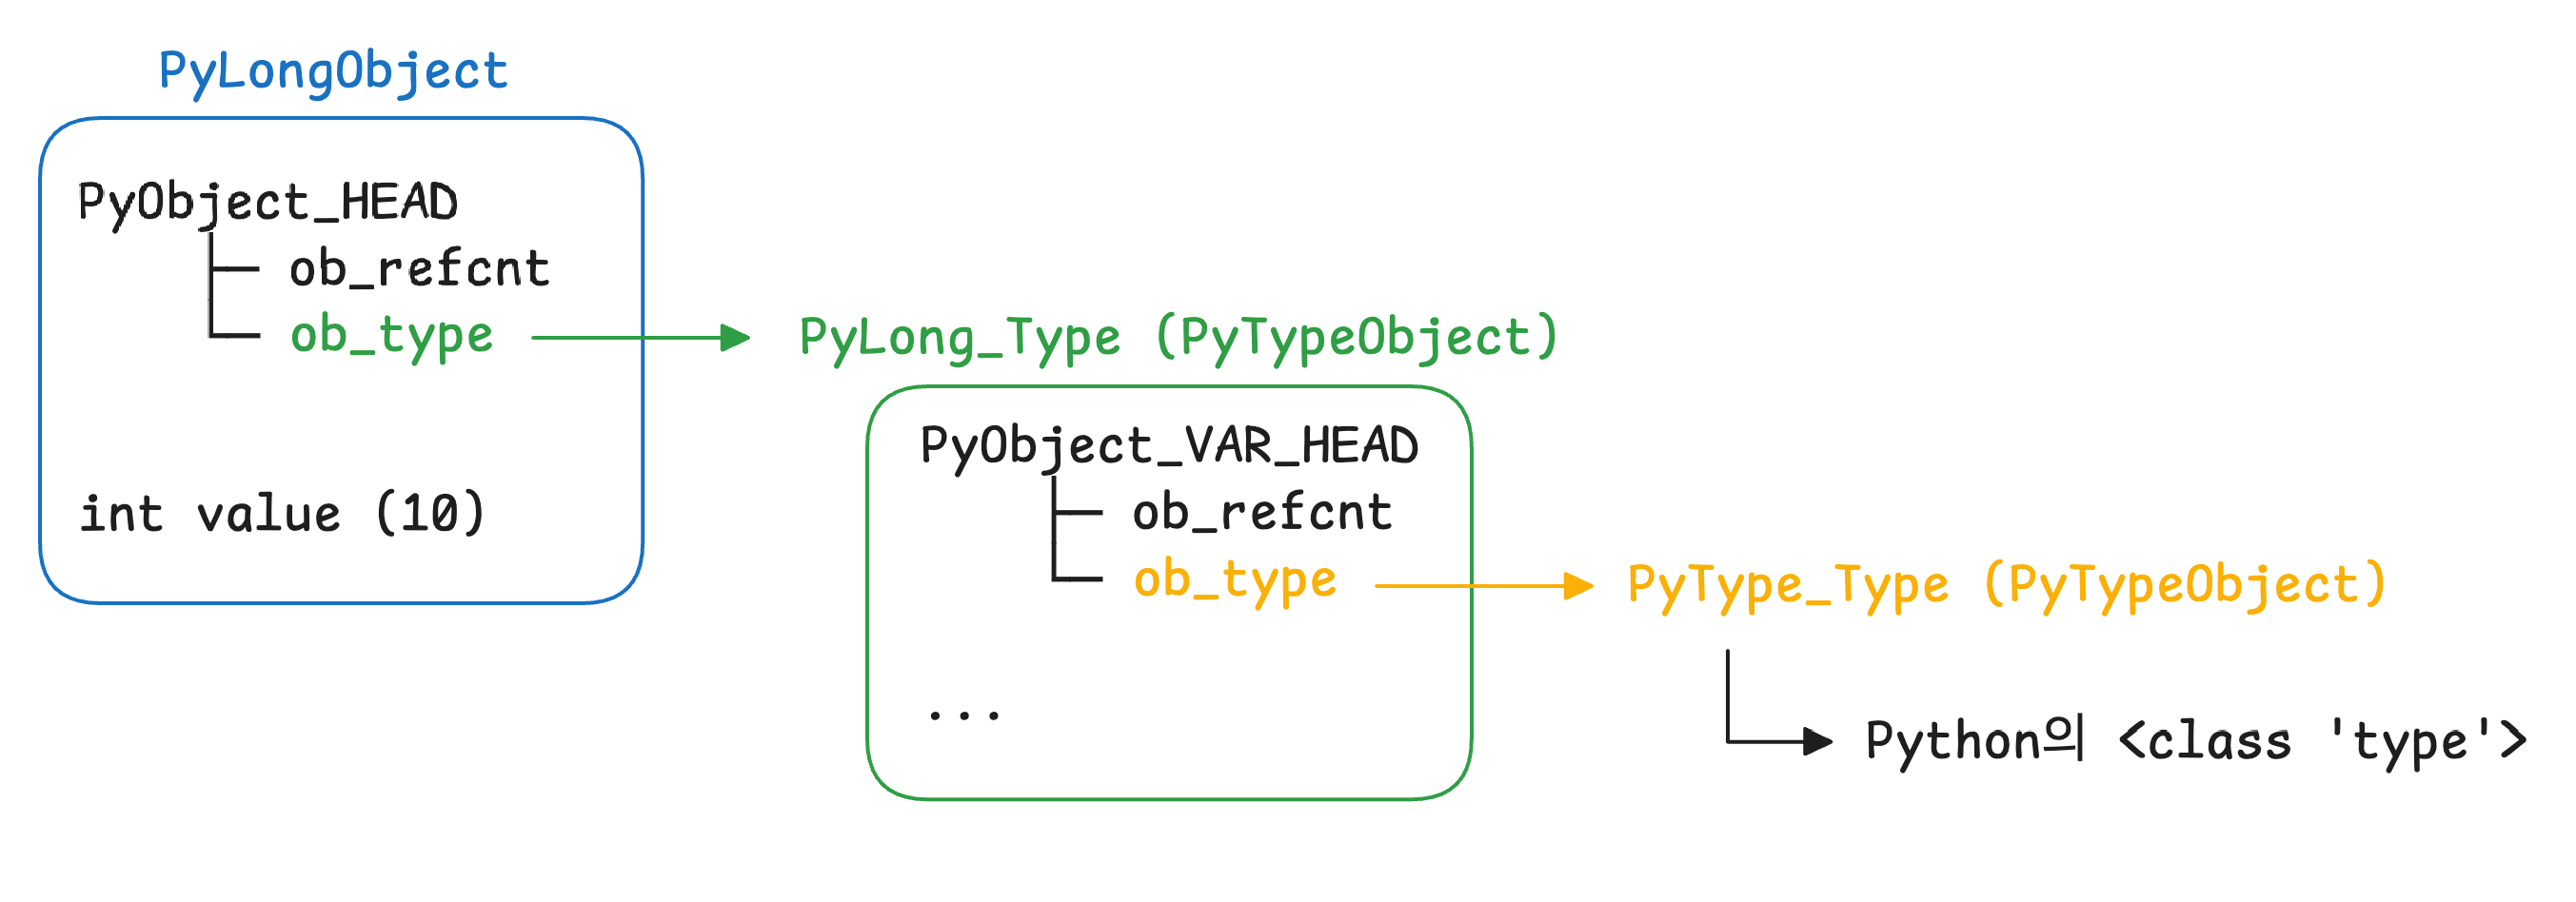
Type Object도 Object
PyLong_Type 역시 Python 객체이므로 앞부분에 PyObject Header를 가지고 있습니다.
따라서 PyLong_Type 역시 자신의 Type을 가집니다.
type(int)
# <class 'type'>
CPython에서는 이를 다음과 같이 표현할 수 있습니다.
Identity & Rich Comparison
Object Model에서는 is가 Identity를, ==가 Equality를 비교한다고 살펴봤습니다.
이 차이는 CPython 내부에서 더욱 명확하게 드러납니다.
Python Object를 다루는 CPython 코드는 일반적으로 Object에 대한 Reference를 PyObject * 형태로 전달합니다.
PyObject *는 위에서 알아보았듯 Python Object의 시작 주소를 가리키는 C Pointer로 두 이름이 동일한 Object를 참조한다면 CPython 내부에서도 결국 같은 Object Pointer를 얻게 됩니다.
is는 이러한 Object Identity를 비교합니다.
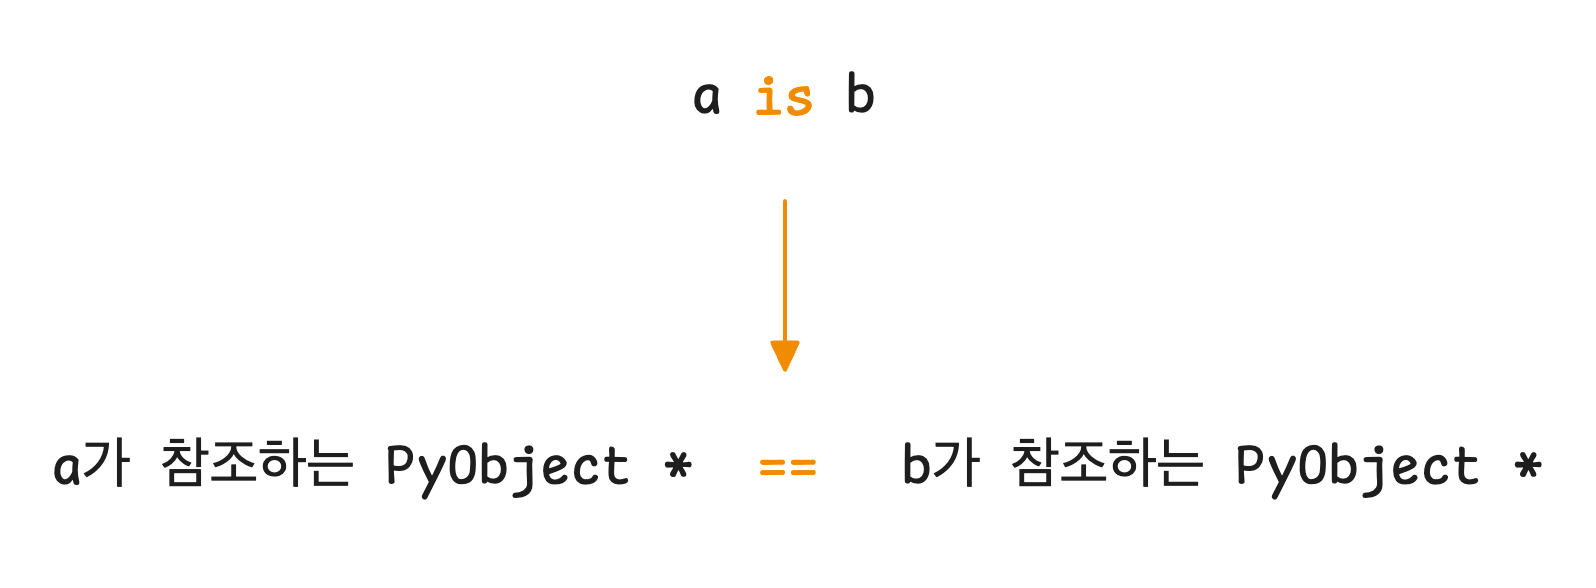
이는 id()를 먼저 호출한 뒤 그 반환값을 비교하는 과정이 아닌, 두 Object Reference가 같은지 비교하는 과정입니다.
반면 ==는 단순한 Pointer 비교가 아닙니다.
CPython에는 <, <=, ==, !=, >, >=와 같은 비교를 처리하는 Rich Comparison 메커니즘이 존재하며, 실제로 두 Object를 어떻게 비교할지는 각 Type이 결정합니다.
예를 들어 다음처럼 Type마다 Equality의 의미가 달라질 수 있습니다.
- int : 숫자 값 비교
- str : 문자열 내용 비교
- list : 각 Element를 순서대로 비교
- 사용자 정의 Class : __eq__에 정의한 동작
PyTypeObject에는 tp_richcompare라는 Slot이 있고 여기에 해당 Type의 비교 함수가 연결되어 있습니다.
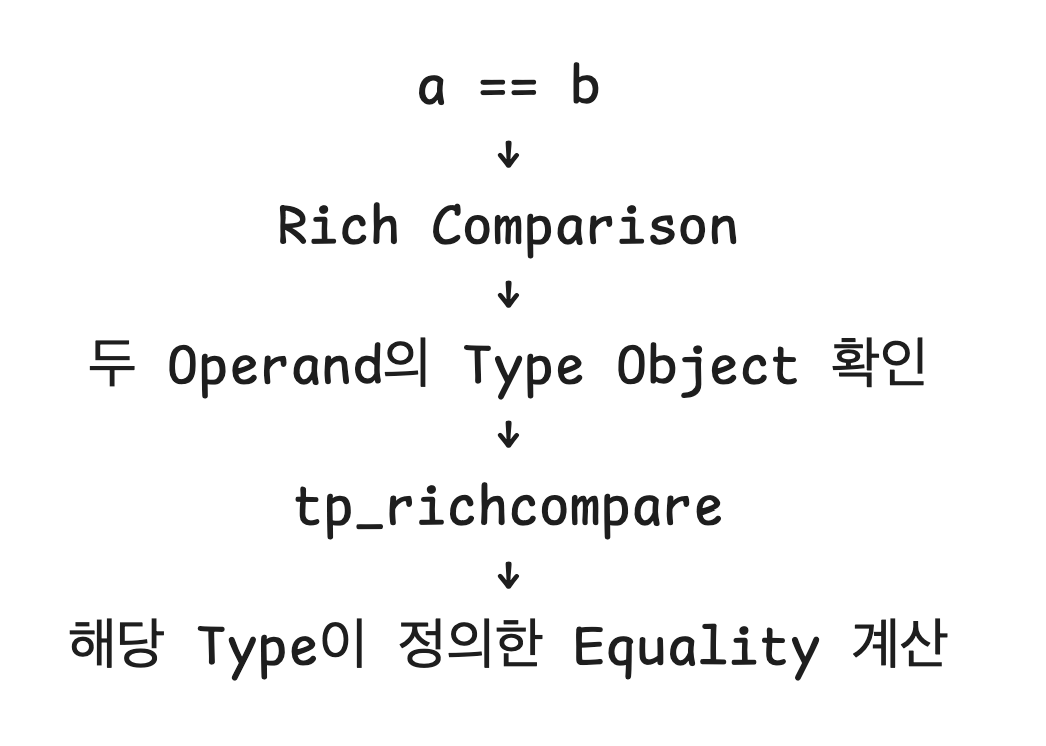
따라서 a == b를 실행하면 CPython은 두 Object의 Type을 확인하고 해당 Type의 tp_richcompare에 연결된 비교 함수를 사용해 Equality를 판단합니다.
Object Allocation
이제 객체의 공통 Header와 Type Object의 역할을 알았으므로 실제 객체가 생성될 때 메모리가 어떻게 준비되는지 살펴볼 수 있습니다.
앞선 Memory Management 편에서는 다음과 같은 흐름을 살펴보았습니다.
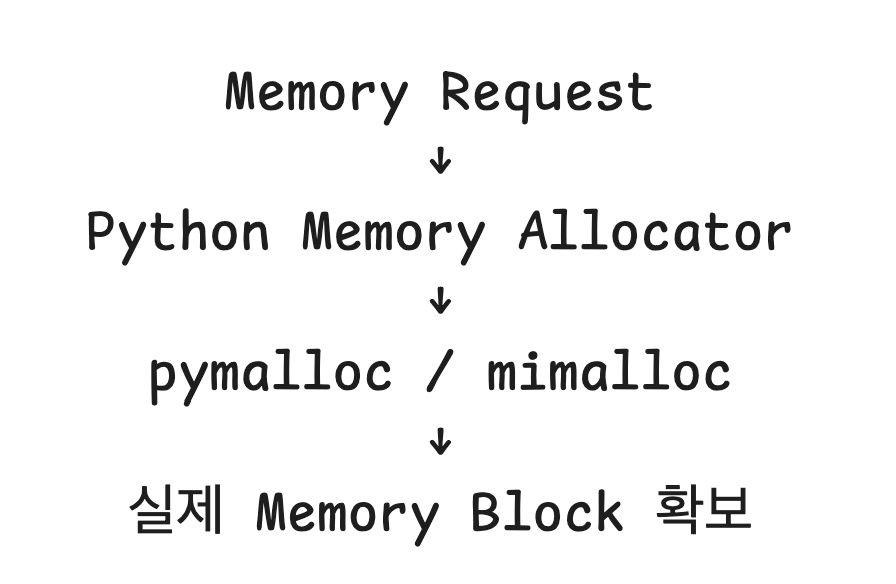
하지만 그 전에 "얼마나 큰 Memory Block을 요청해야 하는가?" 가 결정되어야 합니다.
CPython은 해당 객체의 Type Object를 통해 이를 판단할 수 있습니다.
PyTypeObject에는 다음과 같은 필드가 존재합니다.
Py_ssize_t tp_basicsize;
Py_ssize_t tp_itemsize;
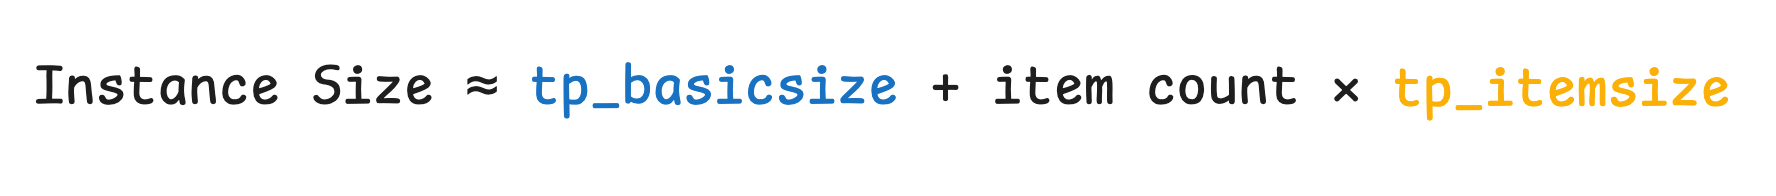
tp_basicsize는 해당 Type의 Instance 하나가 기본적으로 필요로 하는 메모리 크기입니다.
고정 크기 Instance라면 일반적으로 Instance Size ≈ tp_basicsize 가 되며, 생성 시 원소 수에 따라 크기가 달라지는 Type은 tp_itemsize를 이용할 수 있습니다.
단순화하면 다음과 같이 표현할 수 있습니다.
tp_new와 tp_alloc
Type Object에는 객체 생성과 메모리 할당을 위한 함수 Pointer도 존재합니다.
newfunc tp_new;		// 새로운 Instance를 생성
allocfunc tp_alloc;	// Instance가 사용할 Memory를 확보
Python의 호출과 연결해서 단순화하면 다음과 같습니다.
class MyClass:
    def __new__(cls):
        ...

    def __init__(self):
        ...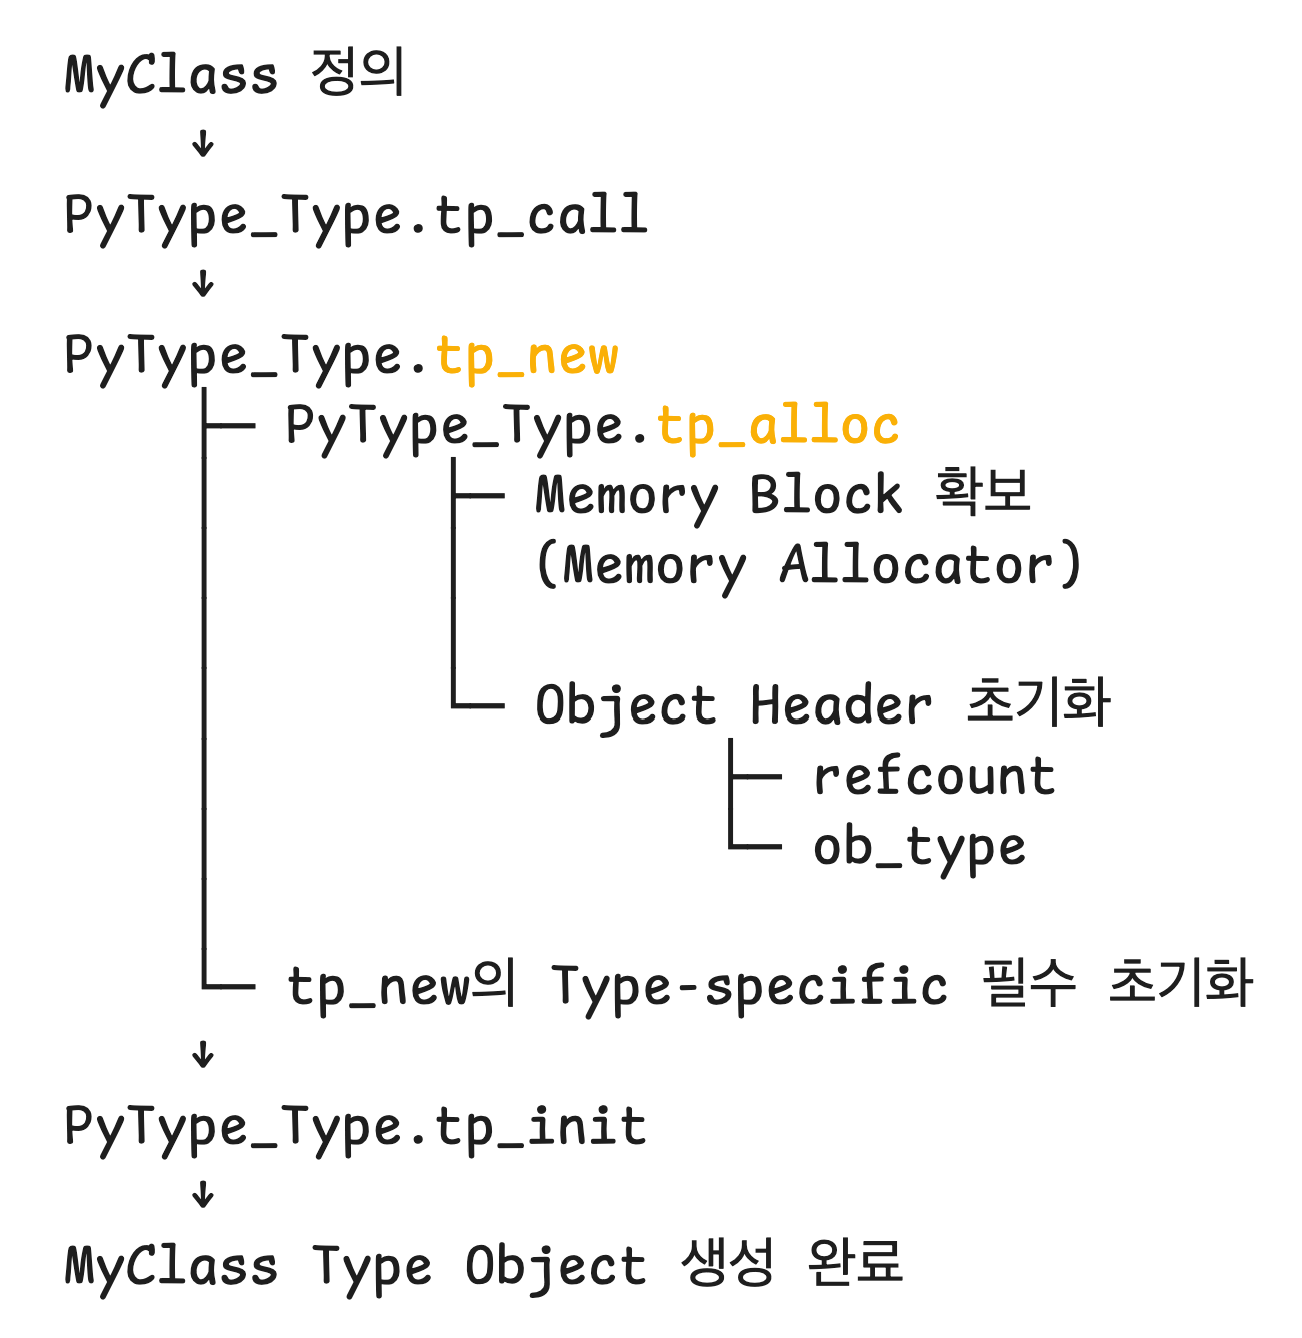
PyType_Type.tp_call: 해당 Type의 tp_new와 tp_init을 통해 인스턴스를 생성·초기화하는 호출 동작
여기서 주의할 점은 MyClass Type Object를 생성하는 단계에서는 아직 MyClass의 인스턴스를 만드는 것이 아니므로 클래스에 정의한 __new__()와 __init__()이 호출되지 않습니다. 대신 기본 metaclass인 type(PyType_Type)의 tp_new와 tp_alloc을 통해 MyClass라는 Type Object 자체를 생성합니다.
obj = MyClass()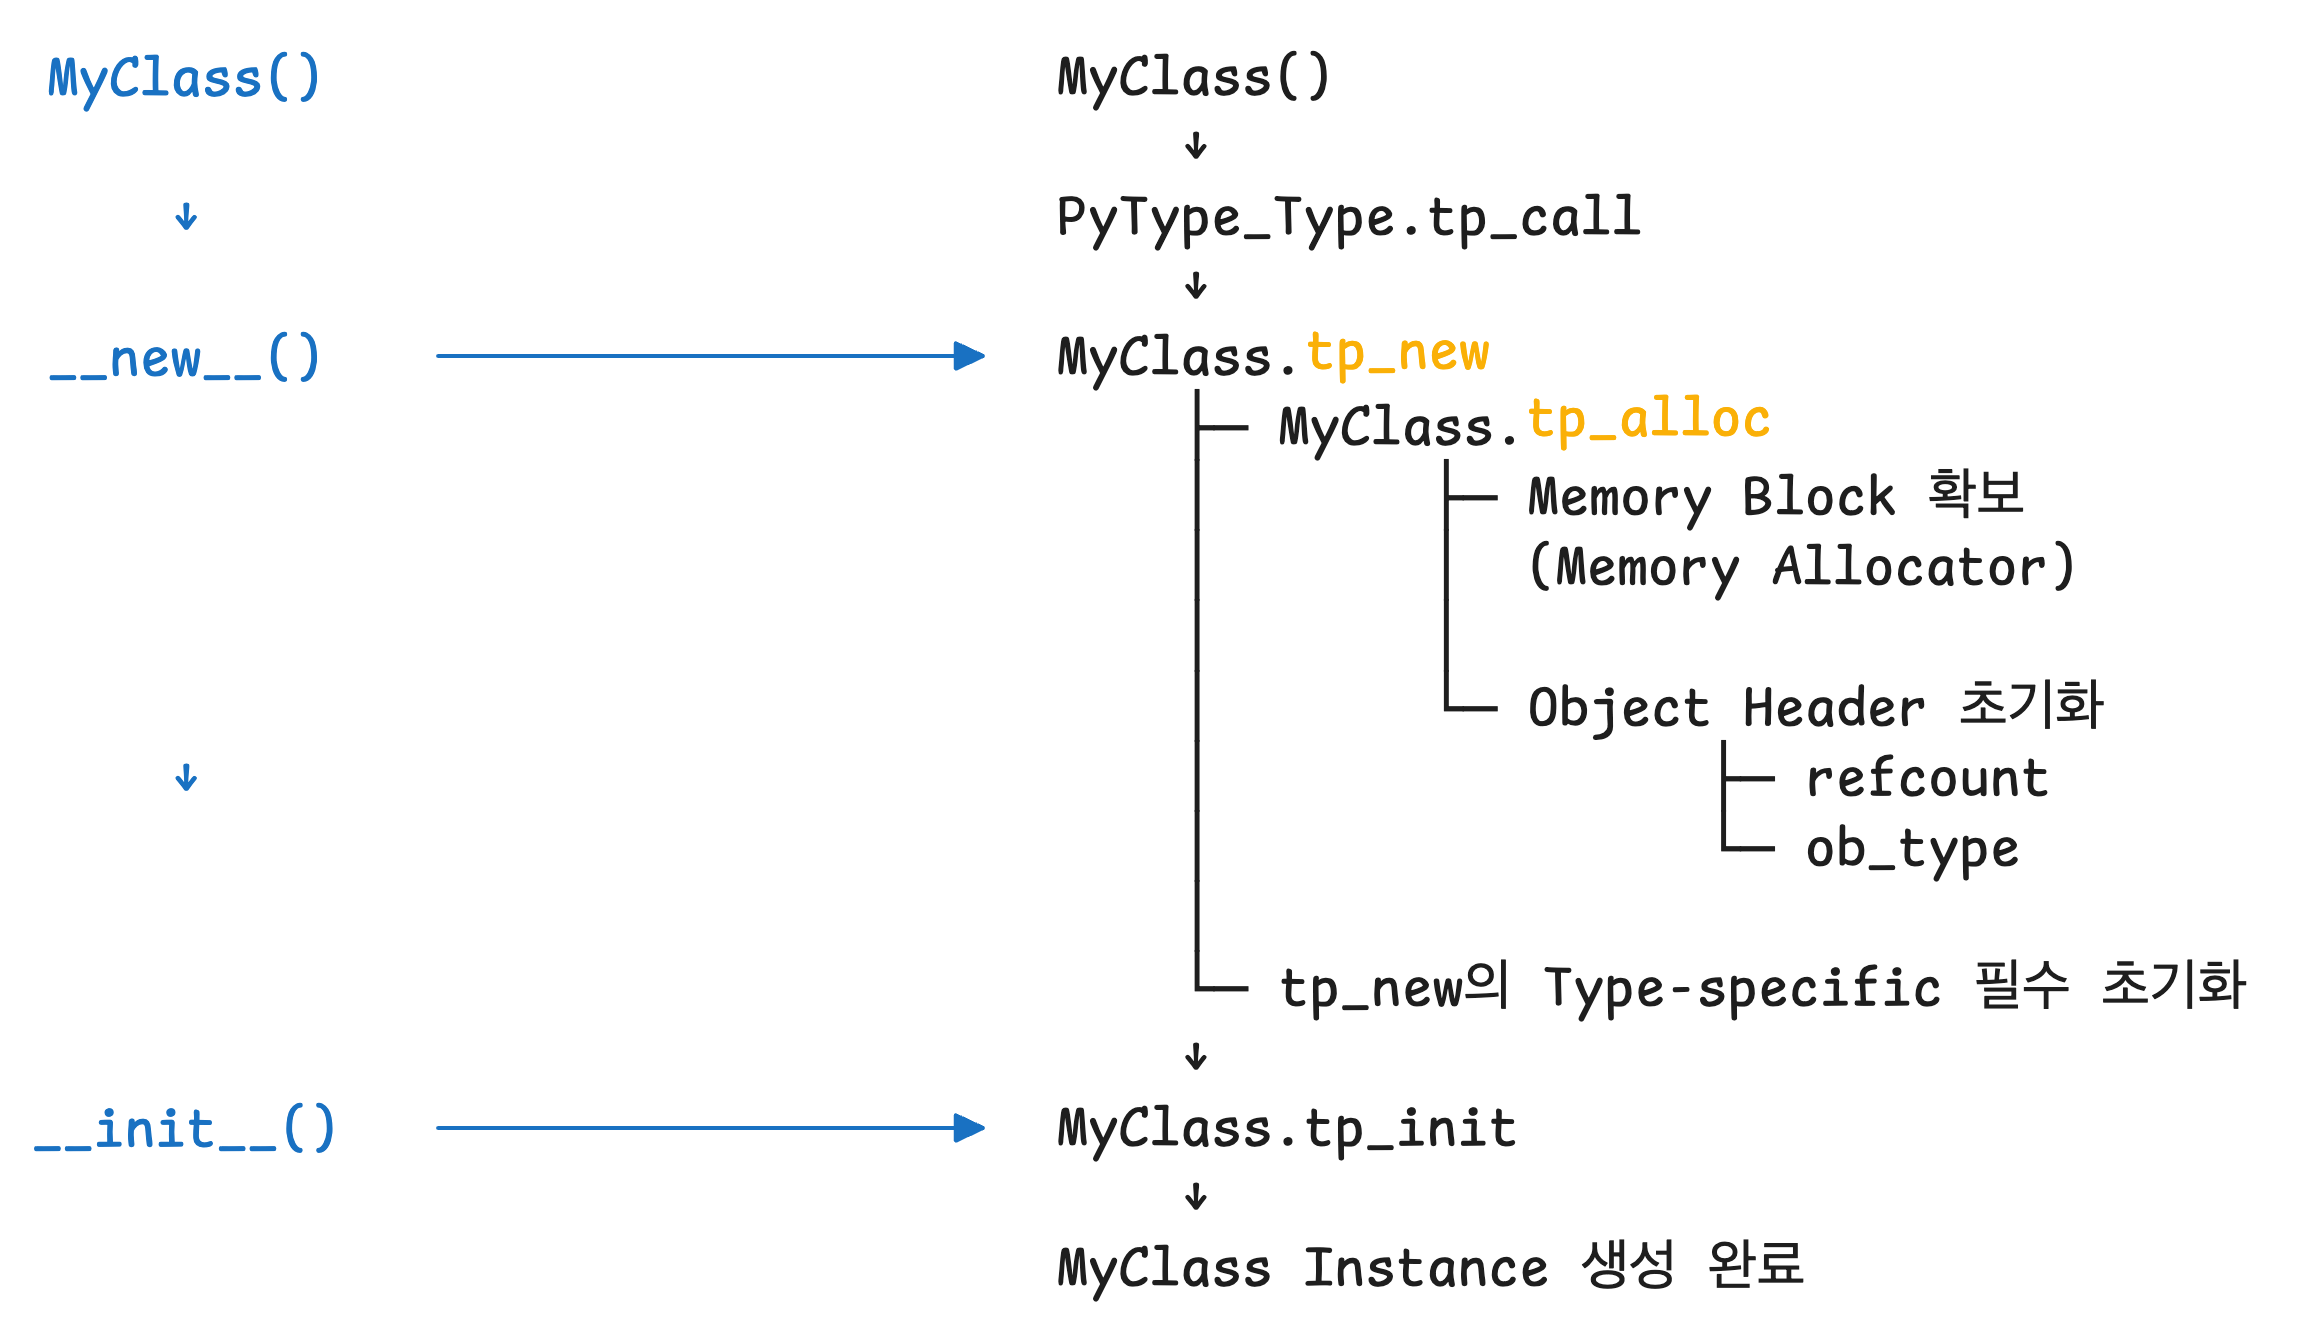
기본적인 Instance Allocation(tp_alloc)에는 PyType_GenericAlloc()을 사용할 수 있습니다.
이 함수는 Type에 필요한 크기의 Memory를 확보하고 해당 영역을 초기화한 뒤 PyObject 또는 PyVarObject Header까지 설정합니다.
여기서 앞선 Memory Management의 Memory Allocator와 비교해 단순화하면 다음과 같습니다.
- Type Object: 얼마나 큰 객체를 어떤 방식으로 생성할지 결정
- Memory Allocator: 요청받은 Memory를 실제로 어디에서 확보할지 결정
int
Python의 int는 CPython에서 PyLongObject로 구현됩니다.
Python의 Integer는 C나 Java의 고정 크기 int와 달리 Arbitrary Precision을 지원합니다.
a = 10

b = 99999999999999999999999999999999999999
위 a 와 b 모두 동일한 int Type입니다.
따라서 실제 정수 데이터의 크기는 값에 따라 달라질 수 있습니다.
현재 CPython의 핵심 구조는 다음과 같습니다.
typedef struct _PyLongValue {
    uintptr_t lv_tag;
    digit ob_digit[1];
} _PyLongValue;

struct _longobject {
    PyObject_HEAD
    _PyLongValue long_value;
};
이를 Python 객체의 관점에서 보면 다음과 같습니다.
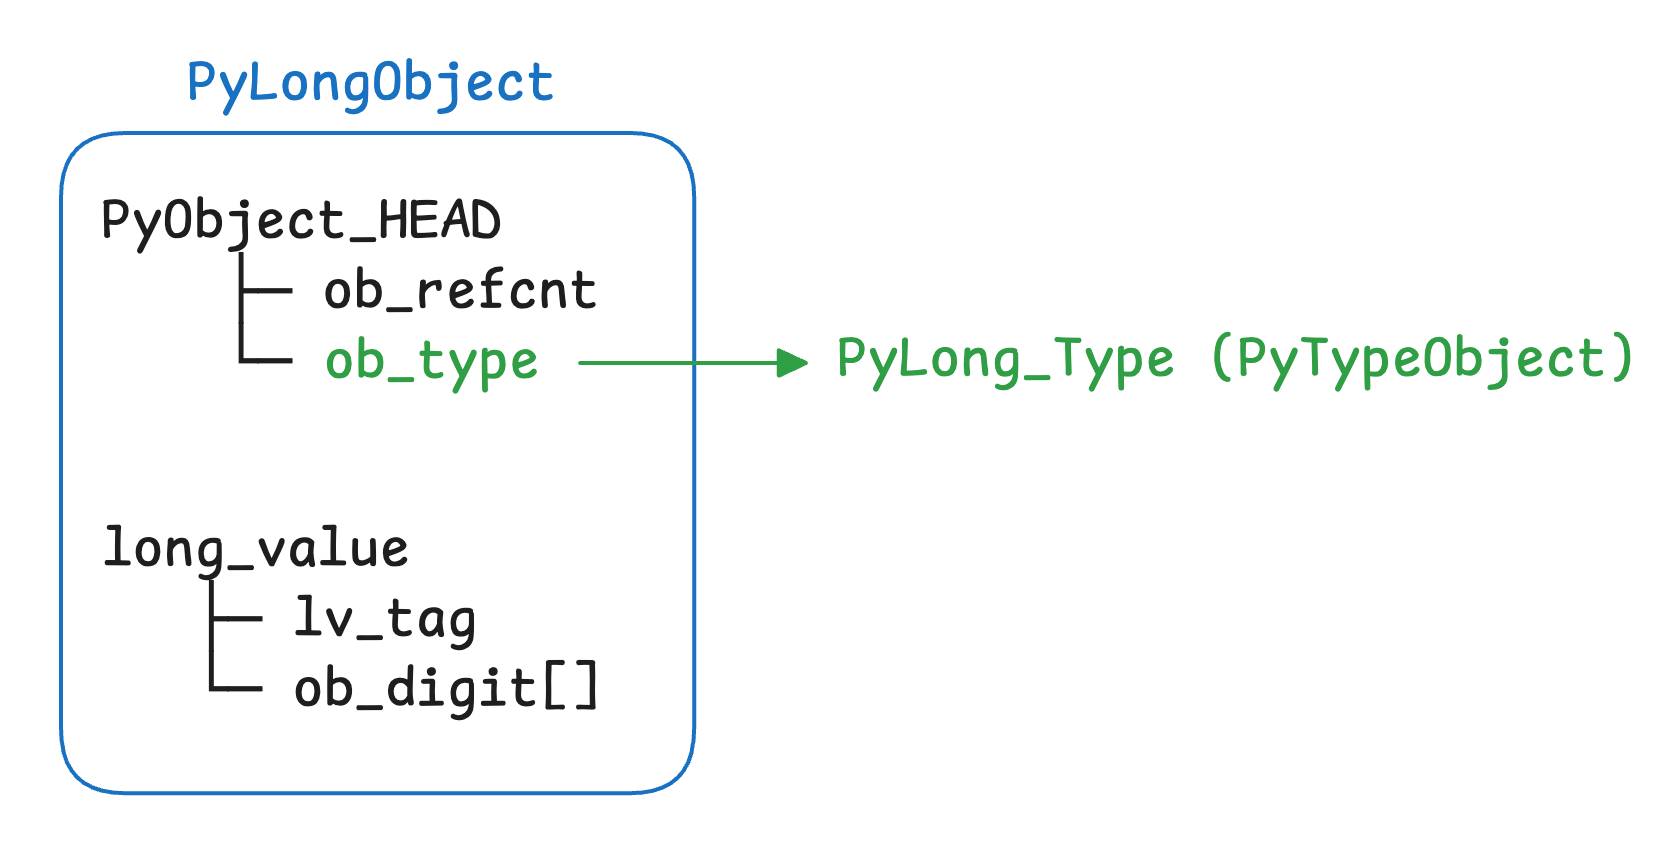
lv_tag에는 부호와 Digit 수 등에 필요한 정보가 들어가며 실제 정수 값은 하나 이상의 digit으로 나누어 표현하며 일반적인 CPython Build에서는 하나의 Digit이 30bit 단위로 값을 표현하기 때문에 값이 커지면 더 많은 Digit을 저장할 공간이 필요합니다.
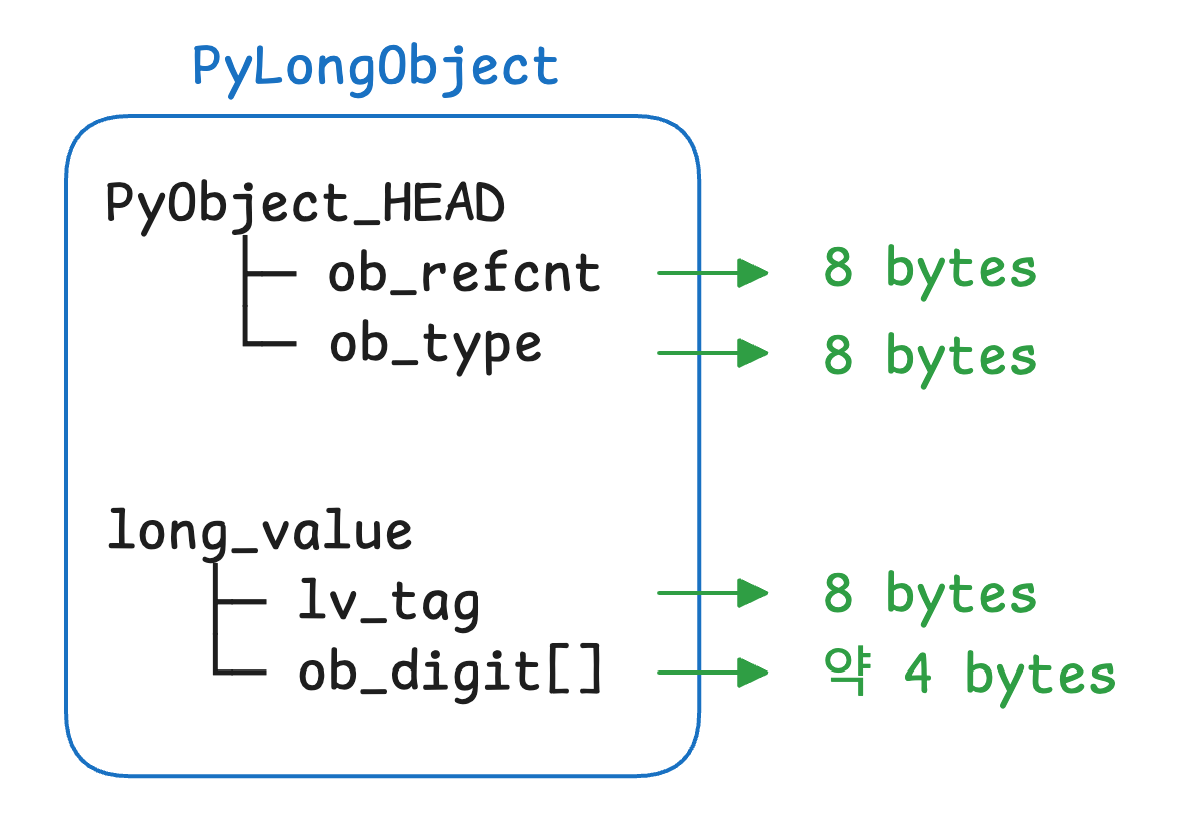
Value의 실제 구현
Object Model 에서는 모든 Object가 Identity, Type, Value 를 가진다고 살펴보았지만 CPython 객체에 공통 Value 필드가 존재하는 것은 아닙니다. Value는 Python 언어 수준의 개념이고 실제 저장 방법은 Type마다 다릅니다.
int는 Immutable입니다.
a = 10
a += 1
따라서 위 코드를 실행한다고 해서 기존 PyLongObject(10)의 내부 Digit을 11로 수정하는 방식으로 이해해서는 안 됩니다.
필요한 경우 새로운 int 객체(PyLongObject)가 사용되고 이름 a가 해당 객체에 다시 Binding됩니다.
다만 CPython은 일부 작은 정수 객체를 미리 생성해 재사용하기 때문에 모든 Integer 표현이 반드시 새로운 Heap Allocation으로 이어지는 것은 아닙니다.
list & tuple
list와 tuple은 다른 Python Object들을 담는 Container입니다.
여기에서 중요한 점은 Container 내부에 다른 객체의 실제 데이터를 복사해 넣는 것이 아니라 다른 Python Object에 대한 Pointer를 저장한다는 것입니다.
list
CPython의 List는 다음과 같이 구현됩니다.
typedef struct {
    PyObject_VAR_HEAD

    PyObject **ob_item;

    Py_ssize_t allocated;
} PyListObject;
이 구조에서 PyObject_VAR_HEAD를 통해
- Reference Count
- Type Pointer
- ob_size
를 가지고 있습니다.
그리고 List에 특화된 두 필드가 추가됩니다.
PyObject **ob_item;
Py_ssize_t allocated;ob_item은 List 원소를 저장하는 Pointer 배열을 가리키는 Pointer입니다.
a = [10, "Python", []]예를들어 위와 같은 리스트가 있다면, 안에 실제로 10, "Python", [] 의 데이터가 그대로 들어있는 것이 아닙니다.
ob_item이 가리키는 배열에는 다음과 같은 Pointer가 들어 있습니다.
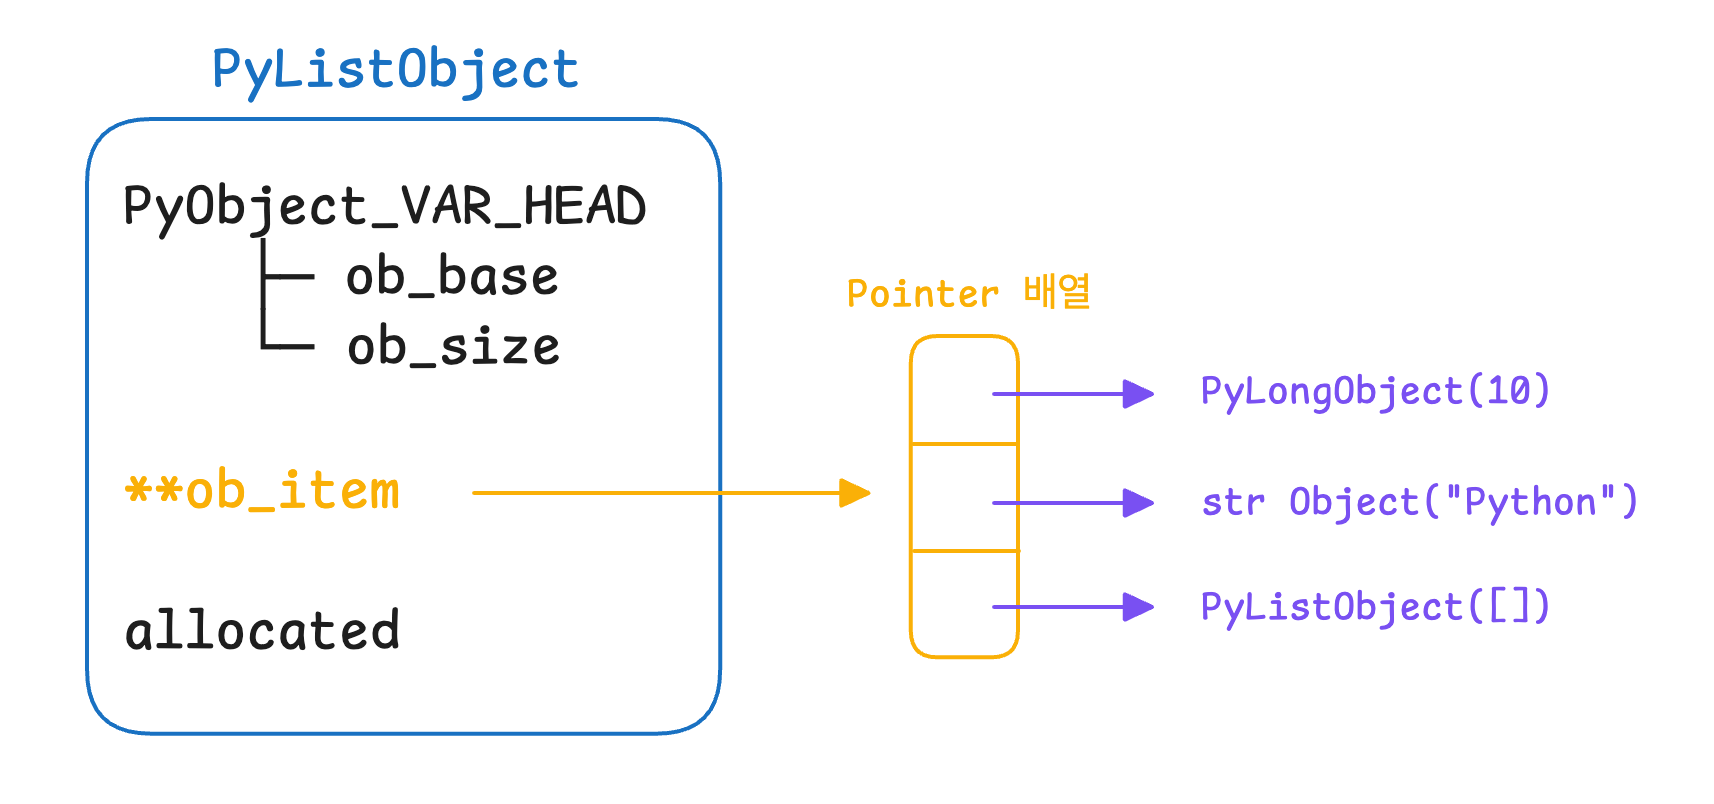
즉 List는 Python Object들의 Reference를 연속된 배열 형태로 보관하는 Container입니다.
서로 다른 Type의 객체도 모두 공통적으로 PyObject *로 표현할 수 있기 때문에 하나의 List에 저장할 수 있습니다.
List의 Memory Allocation
흥미로운 점은 PyListObject 본체와 Element Array가 분리되어 있다는 것입니다.
따라서 List가 커질 때 PyListObject 본체의 메모리 크기를 계속 늘리는 것이 아니라 ob_item이 가리키는 Element Array의 Capacity를 조정합니다.
PyListObject에는
- ob_size → 현재 실제 원소 개수
- allocated → 현재 확보해 둔 Pointer Slot 개수
가 존재합니다.
예를 들어 ob_size = 5, allocated = 8 이라면 실제 원소는 5개지만 Pointer 8개를 저장할 Memory가 확보되어 있습니다.
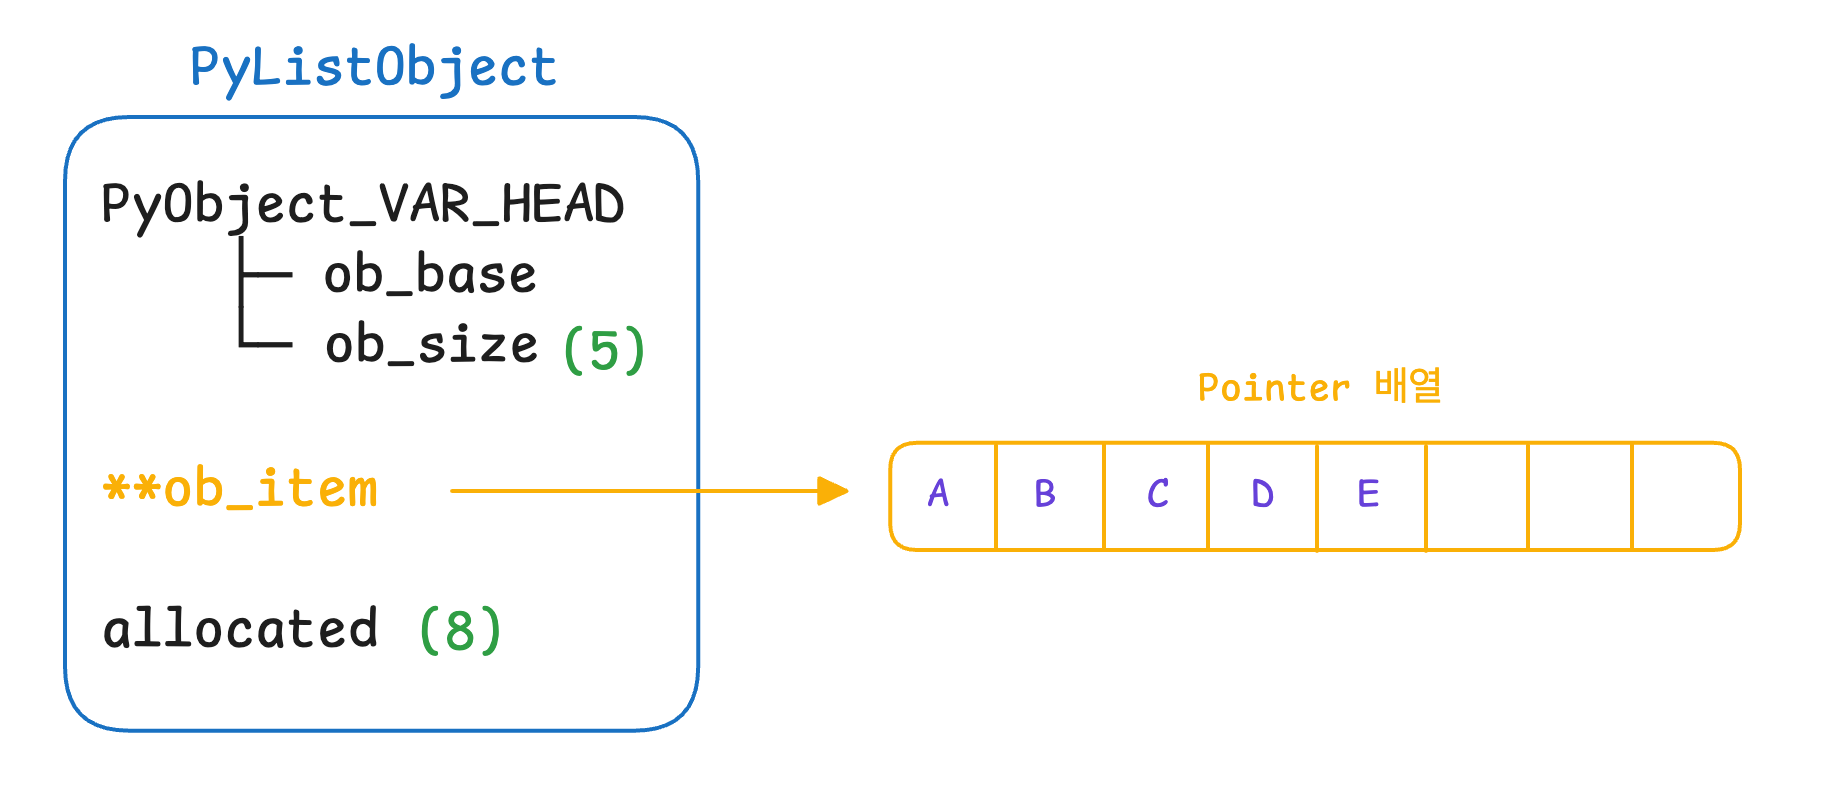
Capacity가 남아 있다면 append() 시 추가 Allocation 없이 Pointer 하나를 새 Slot에 저장할 수 있고, Capacity가 부족하면 더 큰 Element Array를 확보하고 기존 Pointer들을 옮긴 뒤 ob_item이 새로운 Array를 가리키도록 변경합니다.
이것이 List의 Over-allocation 전략과 연결됩니다.
tuple
Tuple 역시 Python Object Pointer들을 저장하지만 Tuple은 생성 이후 크기가 변경되지 않는 Immutable Container입니다.
구조는 다음과 같습니다.
typedef struct {
    PyObject_VAR_HEAD

    Py_hash_t ob_hash;

    PyObject *ob_item[1];
} PyTupleObject;
예를 들어 다음과 같은 튜플은 아래와 같이 표현할 수 있습니다.
t = (10, "Python", [])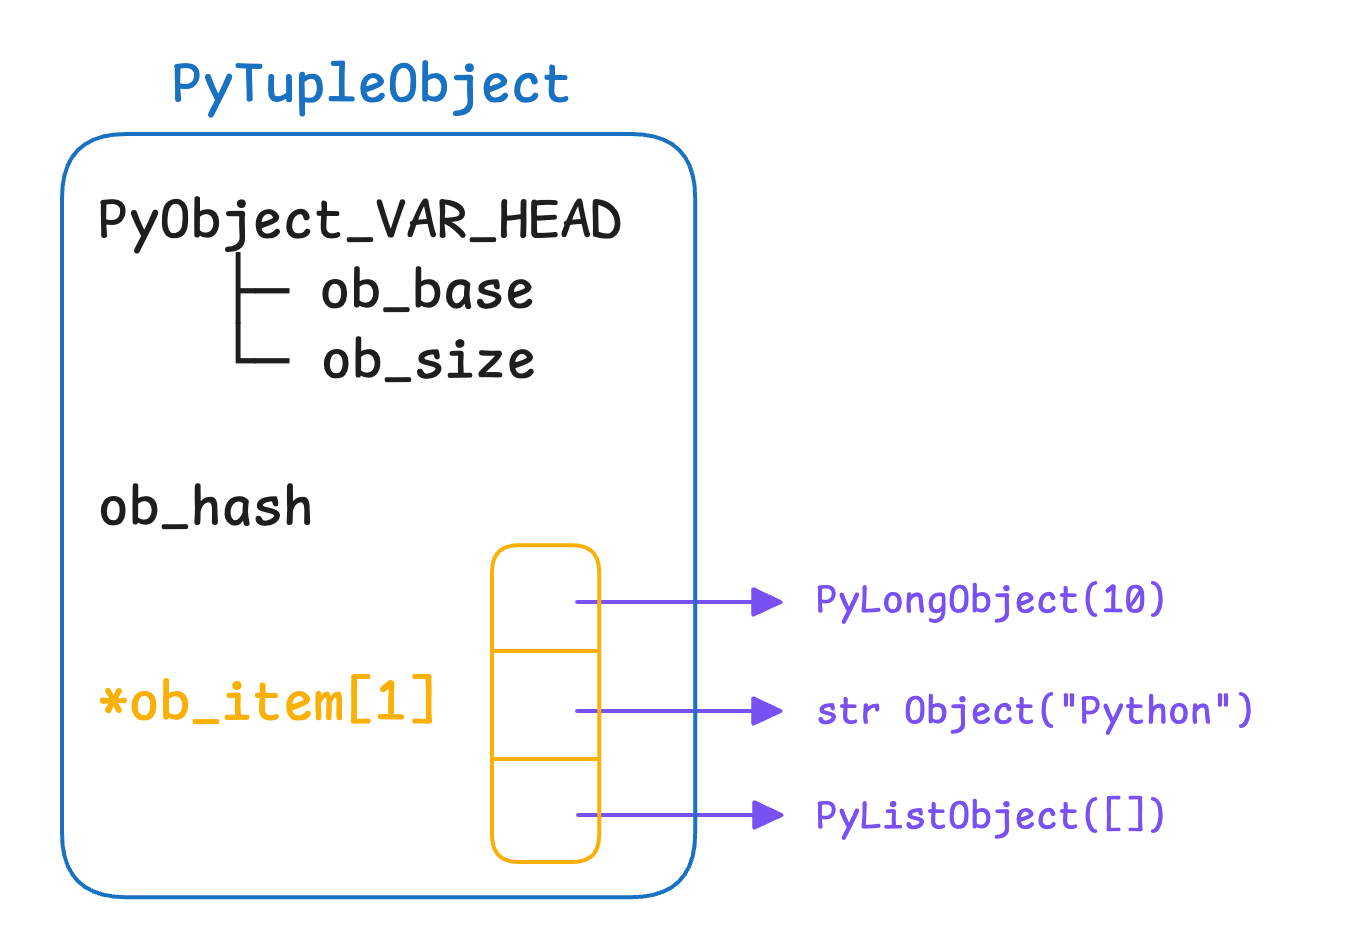
List와 비교하면 중요한 차이가 있습니다.
List는 **ob_item 으로 별도로 할당된 Element Array를 가리키지만,
Tuple의 *ob_item[1] 는 가변 길이 배열 표현으로 실제 Tuple을 할당할 때 필요한 Item 수에 맞는 배열의 공간을 확보합니다.
Tuple은 생성 후 크기가 변하지 않기 때문에 List처럼 별도의 Capacity를 관리하면서 배열을 확장할 필요가 없기 때문에 List와 달리 Tuple은 하나의 연속된 Allocation으로 구성할 수 있습니다.
dict & set
dict와 set은 배열의 Index를 직접 이용하는 Sequence가 아니라 Hash Table을 이용하는 Container입니다.
dict
PyDictObject의 핵심 구조는 다음과 같습니다.
typedef struct {
    PyObject_HEAD

    Py_ssize_t ma_used;

    ...

    PyDictKeysObject *ma_keys;
    PyDictValues *ma_values;

} PyDictObject;
여기서 Dictionary의 실제 Hash Table 전체가 PyDictObject 안에 직접 들어 있는 것은 아닙니다.
ma_used는 현재 Dictionary에 실제로 저장된 Item 수를 나타냅니다.
*ma_keys가 Key와 Hash Table 정보를 관리하는 별도의 구조를 가리킵니다.
또한 구성 방식에 따라 *ma_values가 Value Storage를 별도로 가리킬 수 있습니다.
예를 들어 user 를 다음과 같이 정의했을 때
user = {
    "name": "Python",
    "age": 30,
}"name", "Python", "age", 30이라는 객체가 Dictionary 구조체 안에 값으로 복사되는 것은 아닙니다.
Dictionary의 Entry들은 해당 Python Object들을 참조합니다.
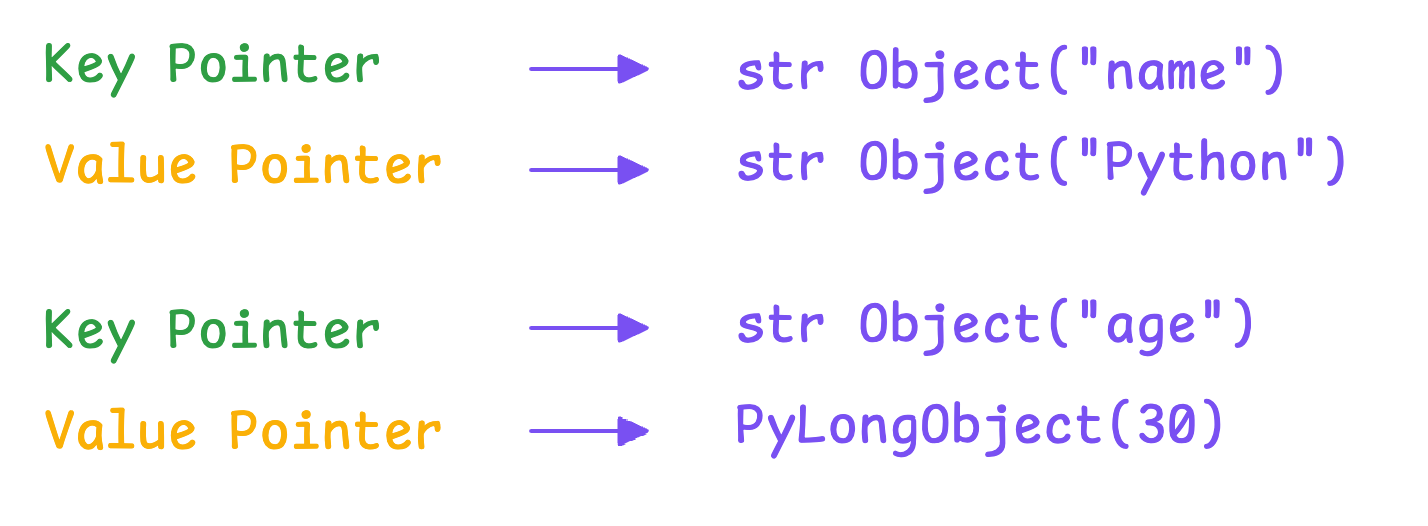
CPython의 Dictionary는 내부적으로 Combined Table과 Split Table이라는 두 형태를 사용할 수 있습니다.
ma_values == NULL이면 Key와 Value를 ma_keys 쪽에서 함께 관리하는 Combined Table이고,
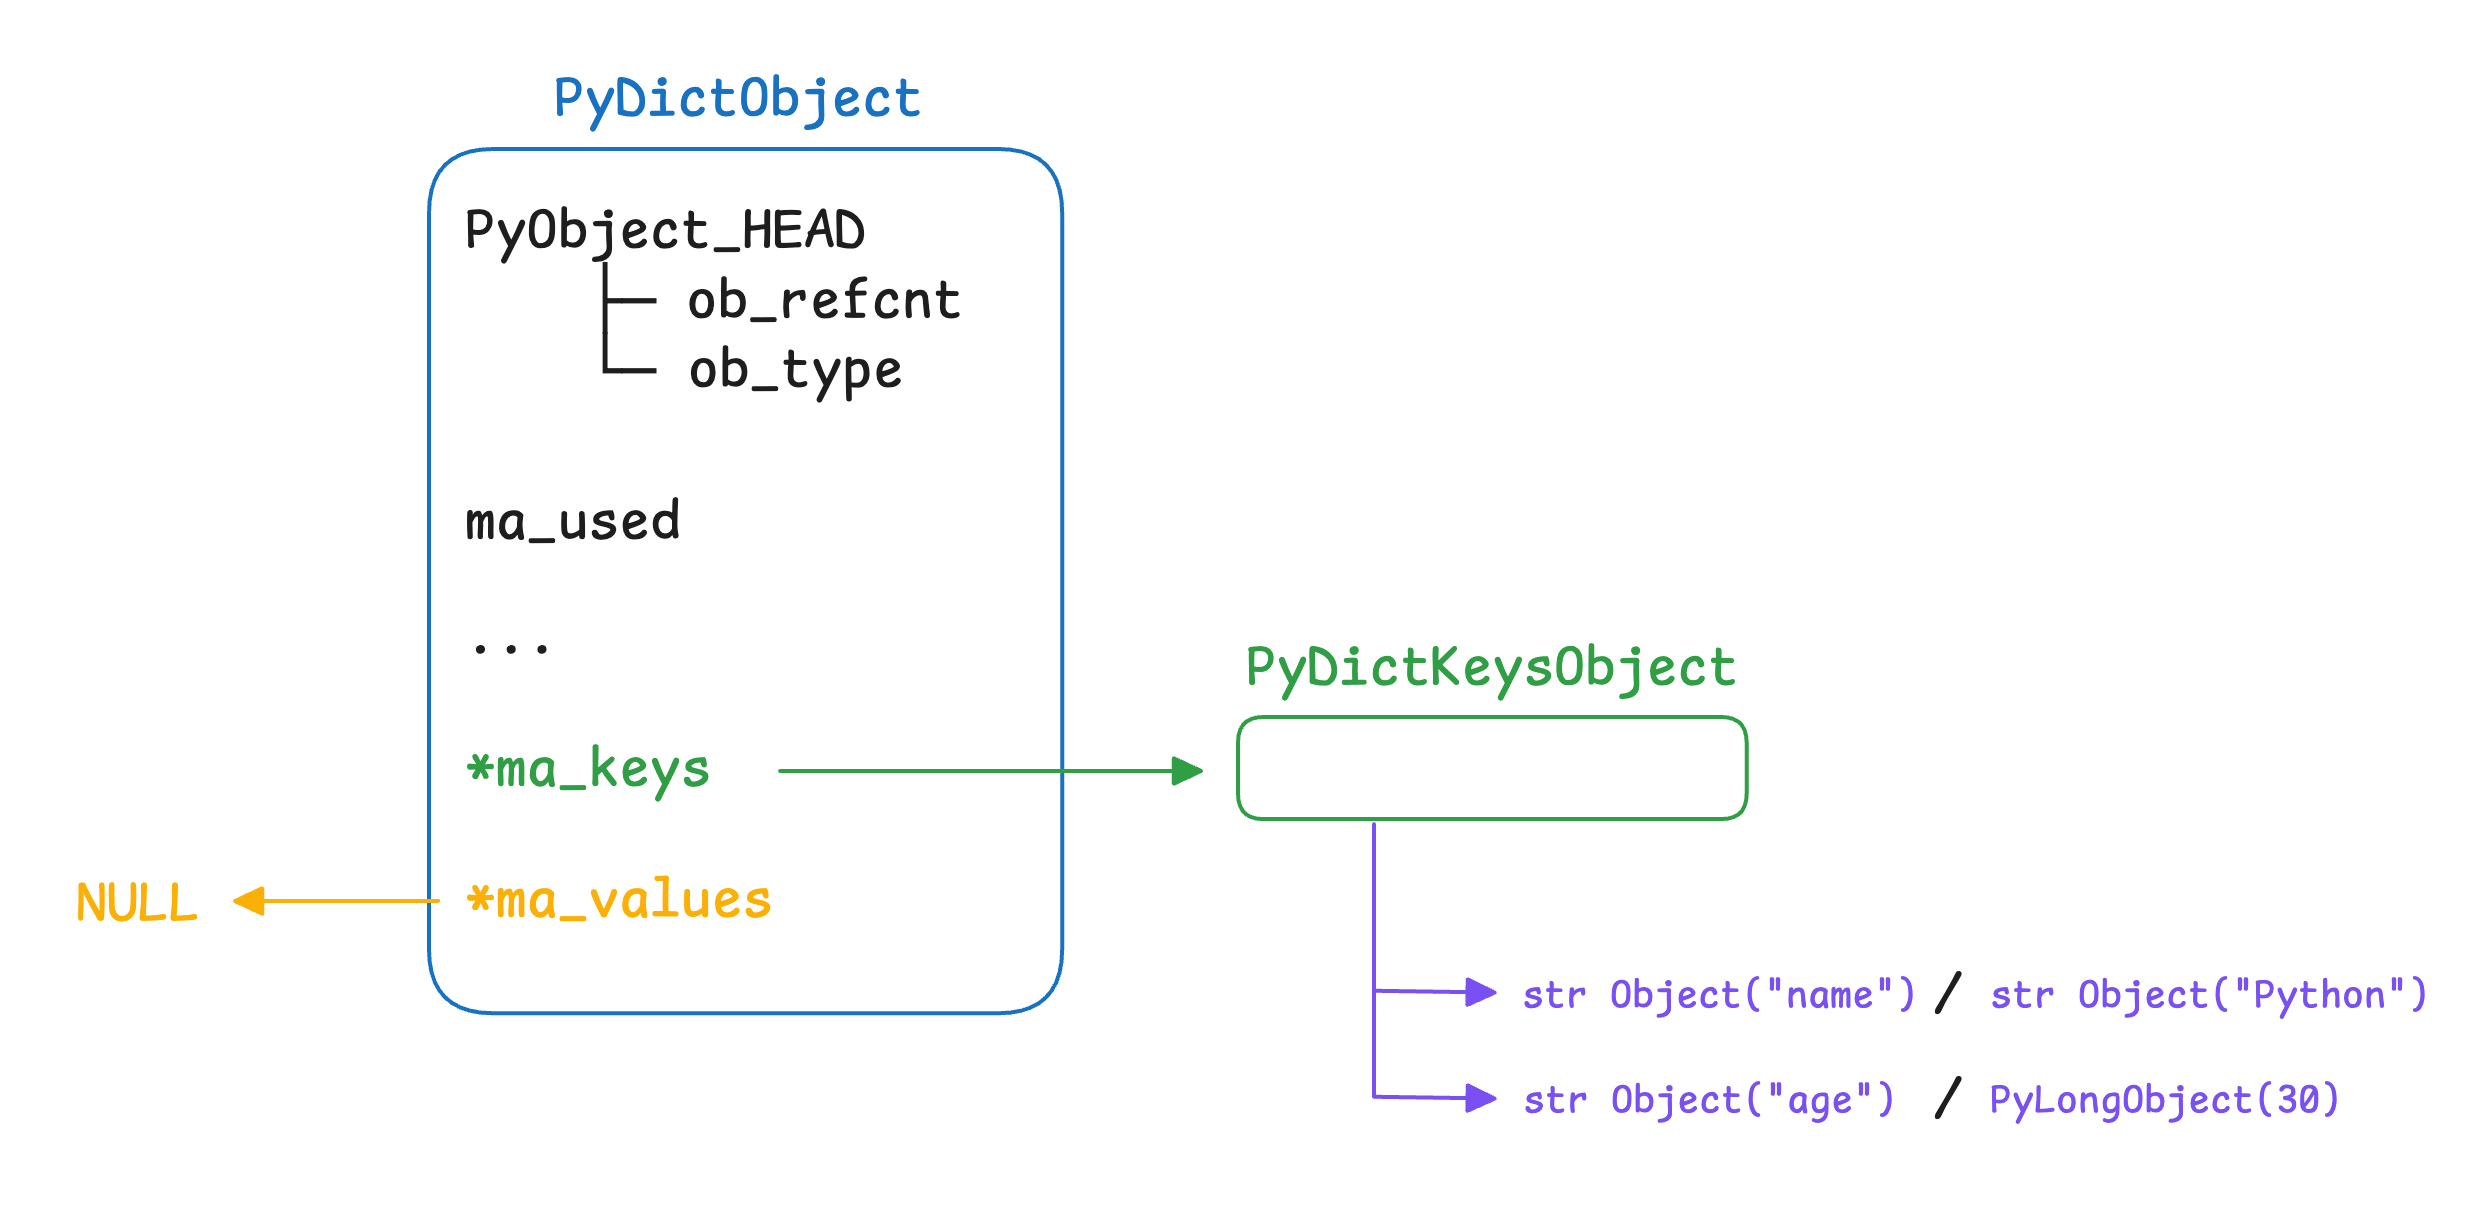
실제 PyDictKeysObject에는 Hash Table의 Index 영역 역할을 하는 dk_indices[] 도 있습니다.
반대로 별도의 ma_values가 존재하면 Split Table 입니다.
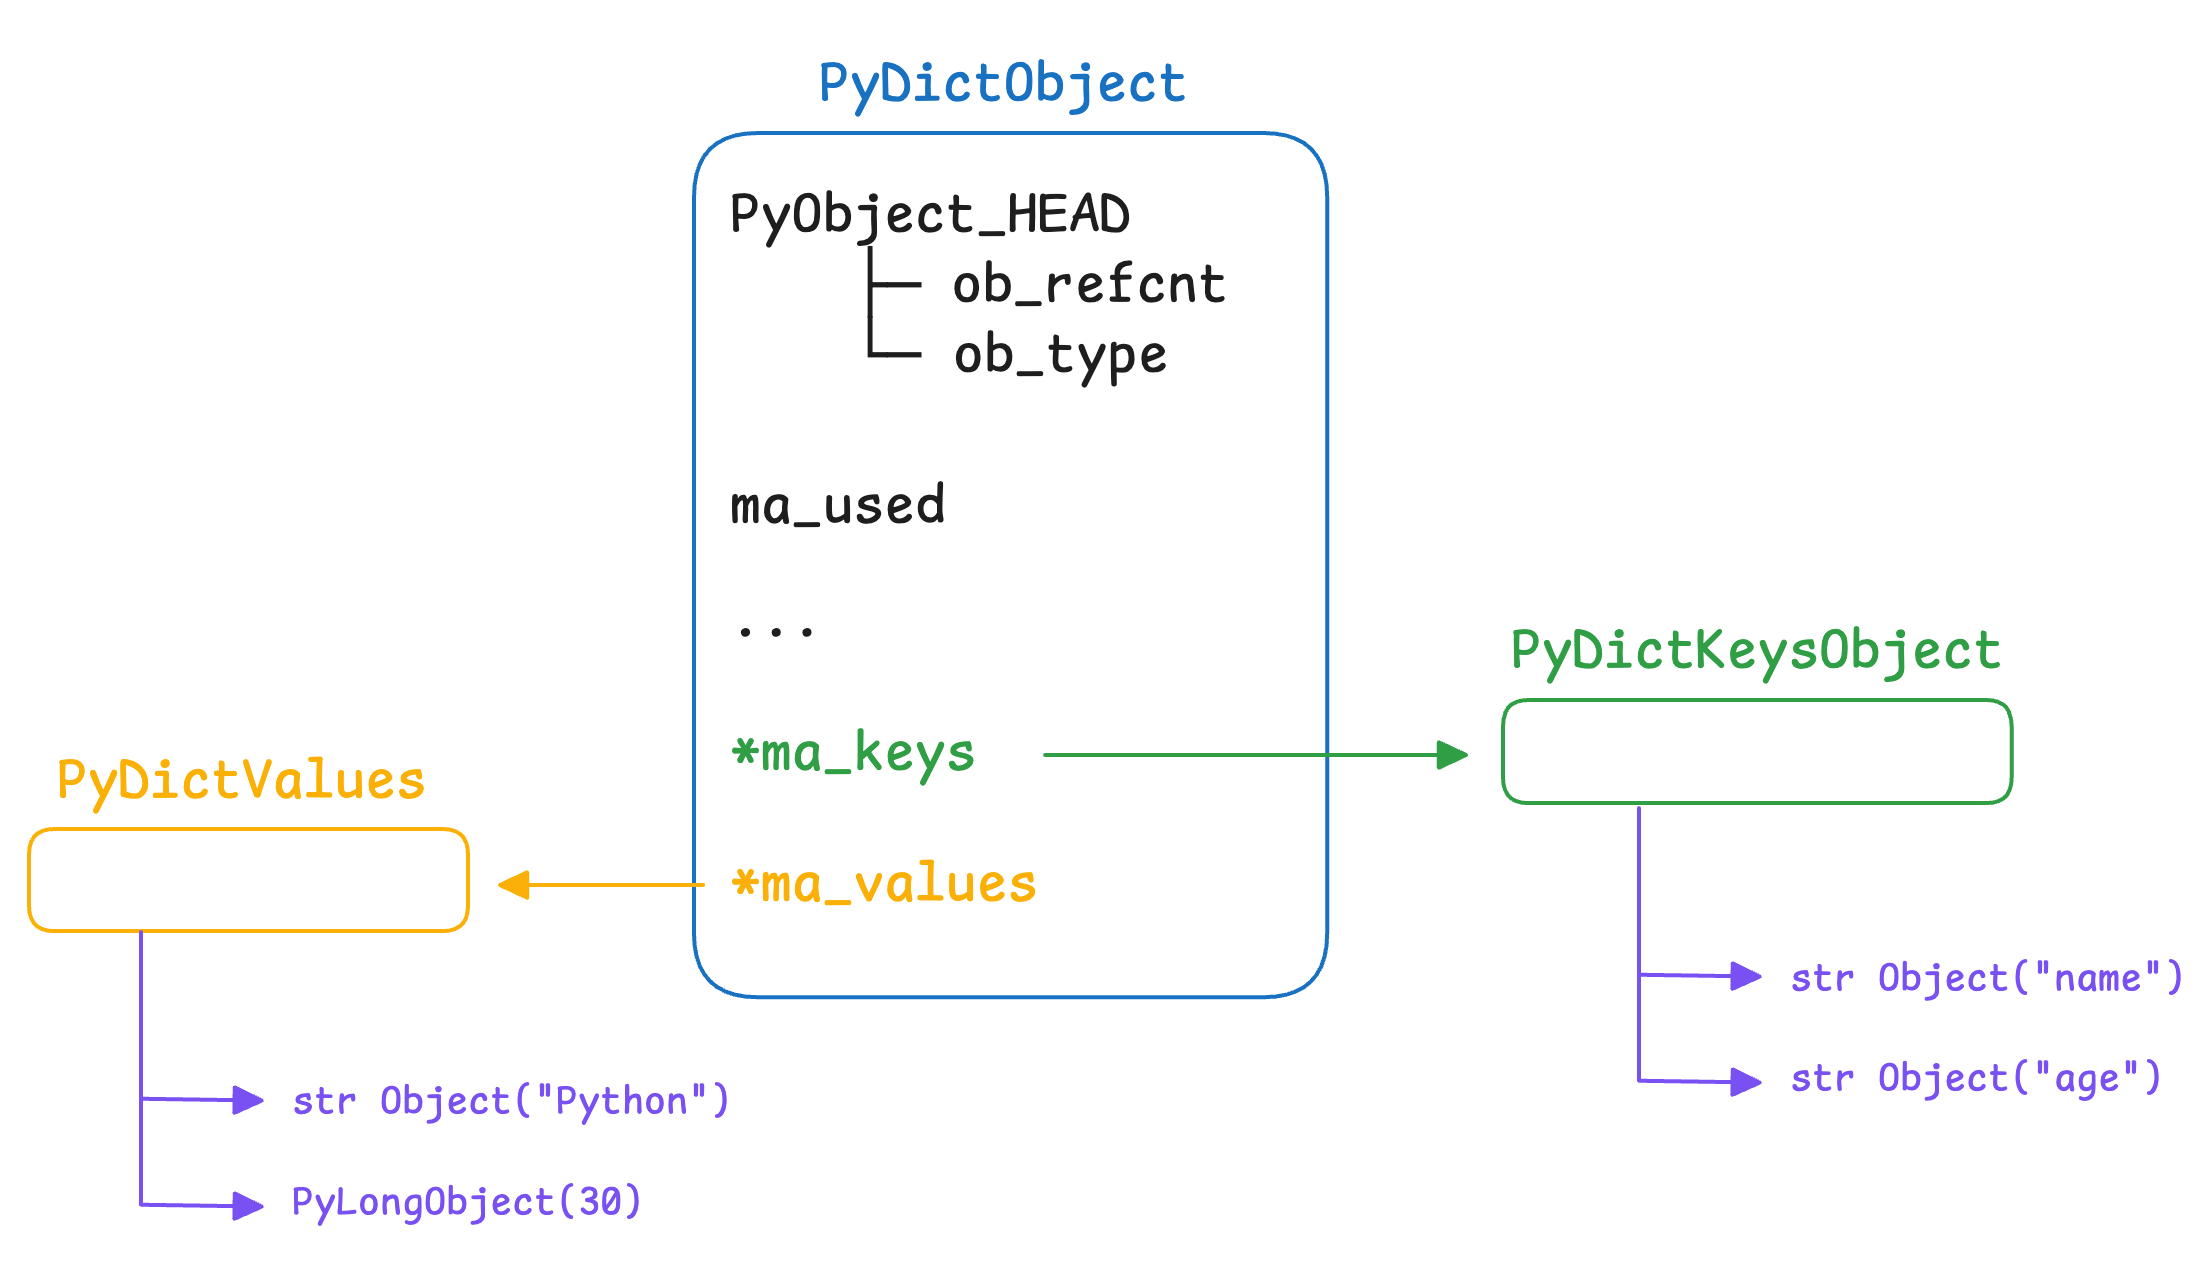
Split Table에서는 Key와 Value를 별도의 저장 공간에 보관되며 이때 Key와 Value는 동일한 Entry Index를 기준으로 매칭됩니다.
이러한 구조는 Dictionary가 사용되는 상황에 따라 메모리를 효율적으로 사용하기 위한 CPython 내부 최적화입니다.
set
Set 역시 Hash Table을 사용하지만 Dictionary와 달리 별도의 Value가 필요하지 않습니다.
하나의 Entry는 다음과 같습니다.
typedef struct {
    PyObject *key;
    Py_hash_t hash;
} setentry;
PySetObject에는 다음과 같은 구조가 존재합니다.
typedef struct {
    PyObject_HEAD

    Py_ssize_t fill;
    Py_ssize_t used;
    Py_ssize_t mask;

    setentry *table;

    Py_hash_t hash;
    Py_ssize_t finger;

    setentry smalltable[PySet_MINSIZE];

    PyObject *weakreflist;
} PySetObject;
여기서 특히 smalltable이 중요한 최적화입니다.
작은 Set은 별도의 Hash Table Memory를 할당하지 않고 객체 내부의 smalltable을 사용할 수 있습니다.
Set이 커지면 *table 이 별도로 할당된 더 큰 Hash Table을 가리키게 됩니다.
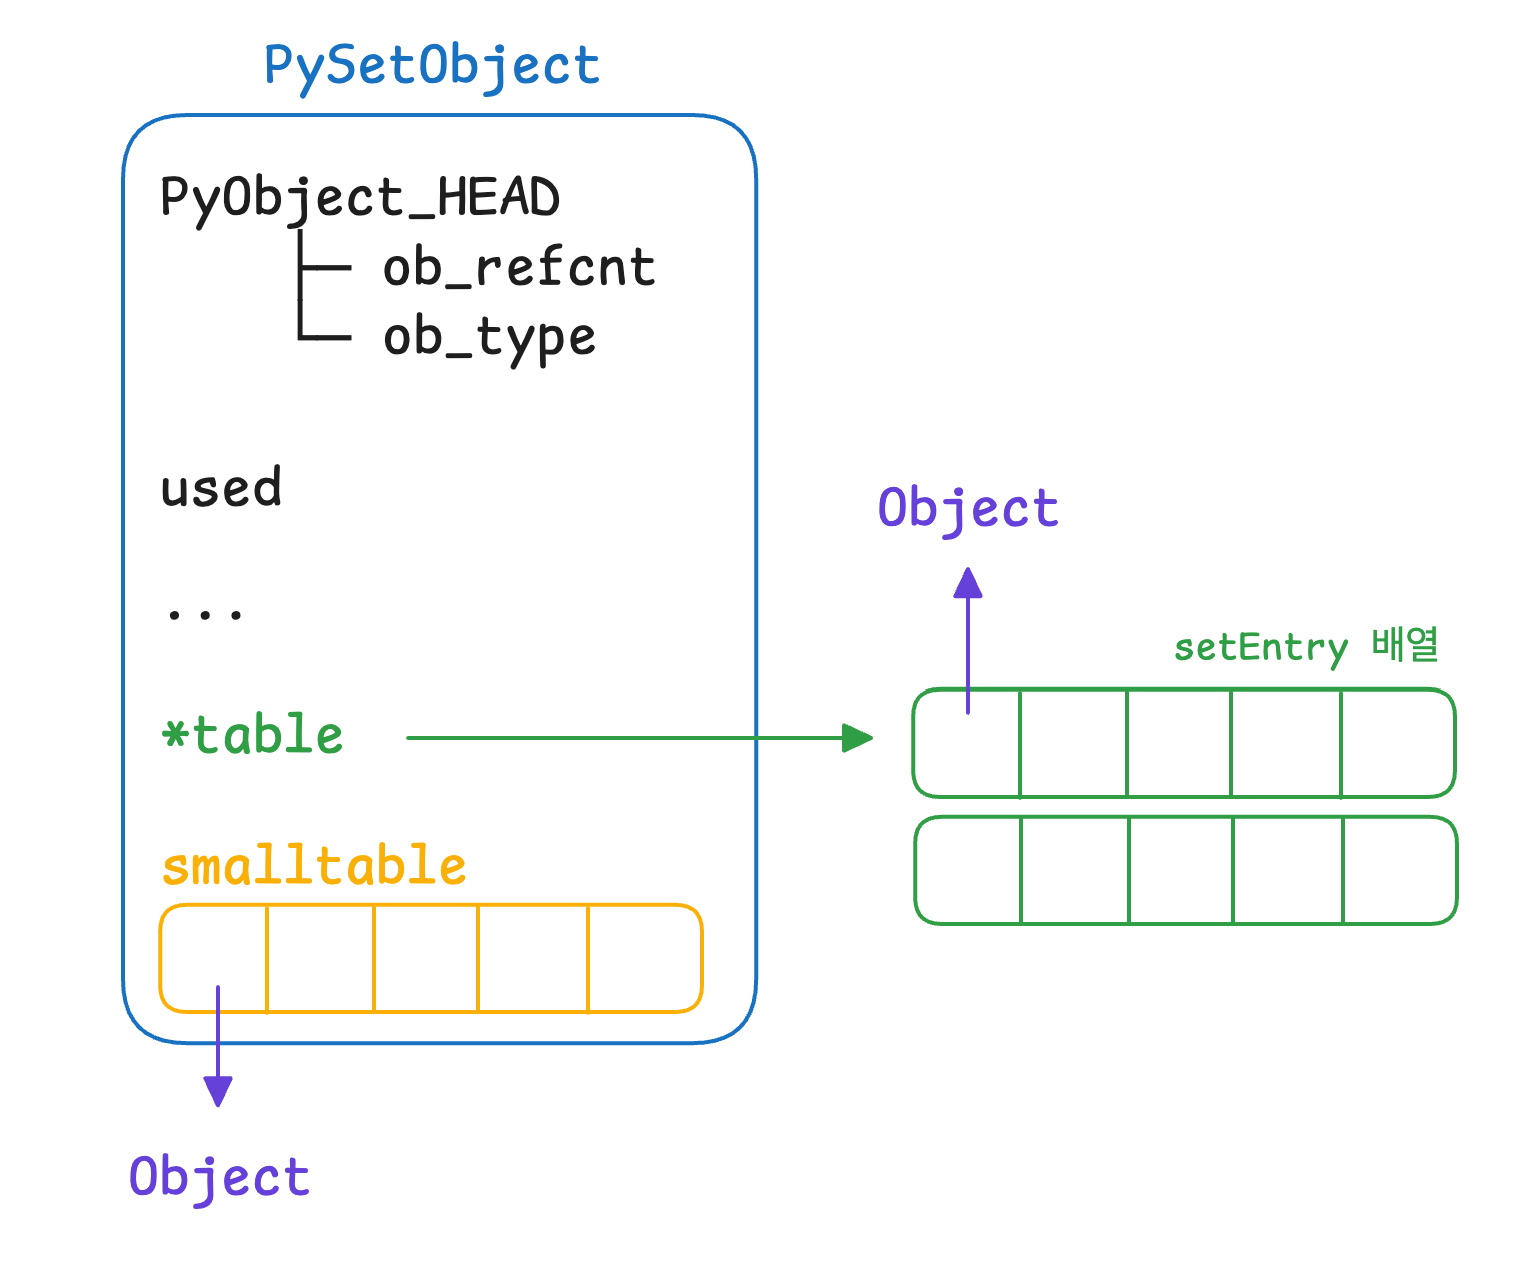
즉 Set은 크기에 따라
- 작은 Set : Object 내부 Storage
- 큰 Set : 별도의 Heap Storage
를 사용할 수 있습니다.
str
Python의 str은 Unicode 문자열입니다.
단순히 C 언어처럼
char *data;하나로 표현되지 않습니다.
모든 Unicode Character를 지원하면서도 ASCII 문자열까지 항상 큰 Character 단위로 저장한다면 상당한 메모리 낭비가 발생합니다.
이를 줄이기 위해 CPython은 PEP 393에 기반한 Flexible String Representation을 사용합니다.
대표적인 내부 구조는 다음과 같습니다.
- Compact ASCII : PyASCIIObject
- Compact non-ASCII : PyCompactUnicodeObject
- Non-compact 형태 : PyUnicodeObject
Compact ASCII
기본적인 Unicode Object Header는 다음과 같습니다.
typedef struct {
    PyObject_HEAD

    Py_ssize_t length;	// 문자열의 Code Point 수
    Py_hash_t hash;	// 계산된 hash

    struct _PyUnicodeObject_state state;  // 문자열의 내부 Representation 정보

} PyASCIIObject;
여기에서도 첫 번째 부분은 동일하게 PyObject_HEAD 입니다.
ASCII 문자열이면서 Compact Representation을 사용하는 경우에는 실제 Character Data가 PyASCIIObject 구조체 바로 뒤에 같은 Memory Block으로 배치됩니다.
예를 들어
s = "hello"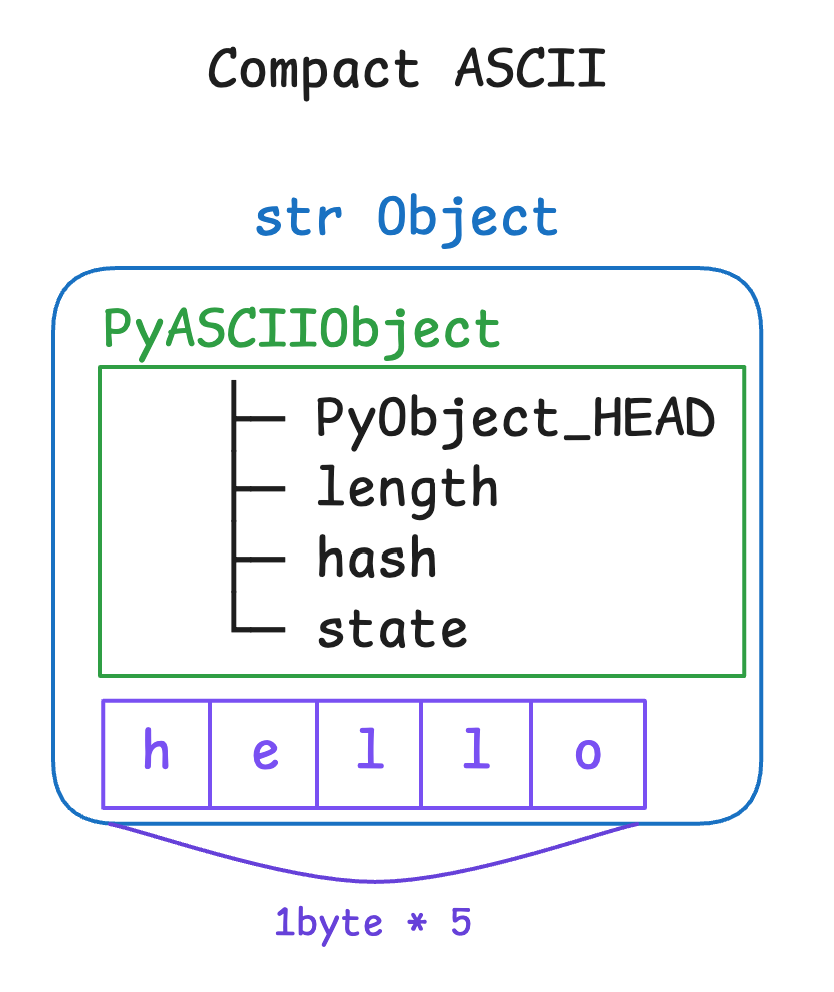
위 그림처럼 하나의 Allocation을 사용할 수 있습니다.
즉 문자열 Metadata와 실제 Character Data를 따로 두지 않아 추가적인 Pointer와 Allocation을 줄일 수 있습니다.
파이썬은 문자열이 사용하는 Character 범위에 따라 실제 Character Data의 단위도 달라집니다.
CPython은 문자열 전체에서 가장 큰 Unicode Code Point를 기준으로 Py_UCS1, Py_UCS2, Py_UCS4 중 가장 작은 표현을 선택합니다. 이들은 각각 1·2·4 Byte의 unsigned integer type이며 문자열 내부의 canonical character buffer에서 문자 하나를 표현하는 단위로 사용됩니다. Compact ASCII는 항상 Py_UCS1을 사용하고, 그 외 Unicode 문자열은 필요한 문자 범위에 따라 1·2·4 Byte 표현을 선택합니다.
Non-ASCII Compact
Non-ASCII Compact String은 다음 구조를 사용합니다.
typedef struct {
    PyASCIIObject _base;

    Py_ssize_t utf8_length;
    char *utf8;

} PyCompactUnicodeObject;
여기에서 PyASCIIObject 를 사용하기 때문에 앞부분에 이미 PyObject_HEAD, length, hash, state 가 포함되어 있습니다.
이 또한 실제 Character Data가 PyCompactUnicodeObject 구조체 바로 뒤에 같은 Memory Block으로 배치됩니다.

즉 String 역시 다른 Python 객체와 마찬가지로 공통 Object Header를 가지면서 Type에 필요한 Data를 추가하는 방식으로 구현됩니다.
Non-compact 형태 (legacy)
일반적인 Python str 객체는 대부분 Compact Representation을 사용합니다.
ASCII 문자열은 PyASCIIObject, non-ASCII 문자열은 PyCompactUnicodeObject 형태를 사용하며 문자 데이터는 객체 구조체 바로 뒤에 같은 메모리 블록으로 배치됩니다.
반면 Non-compact Representation에서는 문자 데이터가 객체와 분리된 별도의 메모리 영역에 존재하고 PyUnicodeObject 내부의 data 포인터가 해당 Buffer를 가리킵니다.
마치며
CPython의 Python 객체는 공통적인 PyObject Header를 기반으로 하며 실제 값과 데이터를 저장하는 방식은 Type마다 다릅니다. 모든 객체는 자신의 Type Object를 가리키고 Type Object는 해당 Instance의 생성·할당·연산·해제 방식을 정의합니다.
int는 여러 Digit으로 정수를 표현하고, list는 별도의 Object Pointer Array를 사용하며, tuple은 Item Pointer 공간을 객체와 함께 할당합니다. dict와 set은 Hash Table 기반 구조를 사용하고, str은 문자열 내용에 따라 내부 Unicode 표현을 선택합니다.
이를 통해 Python의 Object Model이 실제 CPython의 메모리 구조와 어떻게 연결되는지 확인할 수 있습니다.
참고 문서
- Python 3.14 — Common Object Structures
- Python 3.14 — Allocating Objects on the Heap
- Python 3.14 — Type Object Structures
- Python 3.14 — Integer Objects
- Python 3.14 — List Objects
- Python 3.14 — Tuple Objects
- Python 3.14 — Dictionary Objects
- Python 3.14 — Set Objects
- Python 3.14 — Unicode Objects and Codecs
- PEP 393 — Flexible String Representation
'Lang > Python' 카테고리의 다른 글
| [Python] (5) Memory Management (0) | 2026.09.26 |
|---|---|
| [Python] (4) Data Model (0) | 2026.09.26 |
| [Python] (3) Execution Model (0) | 2026.09.22 |
| [Python] (2) Object Model (0) | 2026.09.21 |
| [Python] (1) GIL (0) | 2026.09.21 |